Agentic Goal Engineering : d'abord le bon objectif, puis l'agent
Réponse courte : l'Agentic Goal Engineering clarifie, avant le travail d'un agent d'IA, quel résultat compte comme un succès. L'IA demande le résultat souhaité, pose des questions ciblées et en déduit des critères d'acceptation vérifiables. Les deux figurent dans un Goal Contract (un contrat d'objectif écrit) validé par un humain. Ce n'est qu'ensuite que des agents planifient, construisent et vérifient par rapport à ce contrat. Un premier pilote du 28 octobre 2026 ne prouve pas encore d'avantage par rapport à Spec Kit ni à un modèle sans méthode.
État au 28 octobre 2026 · Auteur : Alexander Weipprecht, Provimedia GmbH · Temps de lecture : environ 35 minutes
De quoi il s'agit
Un agent doit rendre un tableau de bord plus rapide. À la fin, on obtient Lighthouse 100 (la meilleure note de la mesure de performance de Google) et des tests tous au vert, et les chiffres du tableau de bord ont une heure. Ce qui était voulu, c'était rapide et à jour. Ce qui avait été dit, c'était seulement « plus rapide ».
Aucun test ne s'en alarme. Aujourd'hui, les agents de programmation travaillent de façon autonome pendant des heures et s'améliorent en boucle jusqu'à ce qu'une condition d'arrêt soit remplie. Les professionnels appellent la conception de ces boucles le Loop Engineering, et la mise en relation de nombreuses boucles et agents le Graph Engineering. Or une boucle ne vérifie que la condition qu'elle a reçue. Aucune de ces deux disciplines ne remarque si cette condition correspond à ce que l'humain voulait.
C'est là que cet article intervient. Après sa lecture, vous pourrez vérifier une condition /goal (la condition d'arrêt dans Claude Code) à la recherche d'erreurs d'objectif, séparer les propositions d'un agent de vos propres consignes et rédiger des critères d'acceptation qu'un agent aura plus de mal à réinterpréter.
L'état des lieux, en toute honnêteté : Provimedia développe actuellement la méthode sous la forme d'un skill /goalengine pour Claude Code et Code Guardian. Une première comparaison portant sur 120 dialogues est disponible, et elle est défavorable : face à Spec Kit (l'outil de GitHub pour le développement piloté par les spécifications), aucune avance n'est démontrée, et le même modèle sans méthode a cerné l'intention le mieux. La section 9 présente tous les chiffres. Cet article décrit donc une méthode fondée en raison, dont l'utilité n'est pas encore démontrée.
Ce que vous faites dès demain
Cinq gestes que vous pouvez appliquer immédiatement, sans skill et sans connaissances préalables. Ils sont classés selon le niveau de preuve : d'abord ce que le pilote a mesuré, ensuite ce qui est seulement argumenté. Lorsqu'un terme technique apparaît, il figure entre parenthèses ; les sections suivantes l'expliquent.
- Laissez l'agent poser des questions d'abord. Autorisez les questions de clarification et limitez-les à environ huit, par exemple avec : « Avant de commencer : pose-moi jusqu'à huit questions sur ce qui me permettrait de mesurer le résultat. » Il ne vous faut pas de modèle de méthode préfabriqué pour cela. Mesuré : ce bras (le même modèle, sans méthode) a obtenu le meilleur résultat dans le pilote, avec 89,4 % des points corrects. Il n'y avait pas de bras sans aucune question.
- Indiquez derrière chaque exigence de qui elle provient. Soit vous l'avez dite, soit l'agent l'a proposée. Exemple : « Temps de réponse de 5 secondes au maximum (proposition de l'IA, pas encore confirmée) ». Elle ne vaut comme consigne que lorsque vous la confirmez. Dans la méthode, cette étiquette s'appelle
AI_PROPOSED. Mesuré avec la méthode B, qui utilise de telles étiquettes : 0,2 % de points adoptés à tort, contre 4,4 ou 6,8 %. La contribution de l'étiquette seule n'est pas isolée. - Gardez les points ouverts visibles. Ce que personne n'a confirmé n'est pas supprimé, mais noté comme ouvert. Exemple : « Ouvert : quel âge maximal les chiffres peuvent-ils avoir ? Pas encore clarifié. » Enseignement du pilote.
- Dans la condition
/goal, décrivez l'état, pas la solution. Pas : « Intègre un cache Redis. » Mais : « Le tableau de bord se charge en 1,5 seconde au maximum et affiche des chiffres datant de 60 secondes au maximum. » L'agent peut ainsi trouver lui-même le meilleur chemin. Une question utile à vérifier (section 6) : la réponse modifie-t-elle ce qui compte comme un succès ? Argumenté, non mesuré. - Rédigez les critères de succès de façon à ce que quelqu'un puisse les vérifier. Exemple : « Étant donné : le tableau de bord avec des données de test. Quand : je l'ouvre 20 fois de suite. Alors : chaque ouverture dure 1,5 seconde au maximum, et les chiffres datent de 60 secondes au maximum. Vérification : script de mesure, données brutes conservées. » Ce format s'appelle un critère d'acceptation (la section 7 le présente en entier). Argumenté, non mesuré.
En un coup d'œil
Quelle question vous occupe ? Le tableau donne la réponse courte et la section où elle est justifiée.
| Votre question | Réponse courte | Section |
|---|---|---|
| Pourquoi les agents manquent-ils l'objectif alors que tous les tests sont au vert ? | Chaque boucle ne vérifie que la condition qu'elle a reçue. Si la condition est fausse, l'agent optimise de façon fiable la mauvaise chose. | 1 |
| Quelle différence avec le Loop et le Graph Engineering ? | Le Loop itère jusqu'à la condition, le Graph répartit le travail, le Goal Engineering clarifie au préalable s'il s'agit de la bonne condition. | 2 et 3 |
| Comment la méthode se déroule-t-elle ? | 6 étapes (GE-01 à GE-06), vérifiées par rapport à 7 dimensions de l'objectif. Le résultat est un contrat d'objectif validé. | 4 et 5 |
| Quelles questions l'IA pose-t-elle, et lesquelles non ? | Uniquement des questions dont la réponse modifie ce qui compte comme un succès. 6 étiquettes d'origine séparent vos consignes des propositions de l'IA. | 6 et 4 |
| À quoi cela ressemble-t-il sur un exemple ? | La recherche par IA pour un forum, du souhait vague au critère vérifiable. | 7 |
| Qu'est-ce qui empêche l'agent de réinterpréter l'objectif ? | 2 contrôles de qualité (avant et après la mise en œuvre), 5 mesures de protection contre l'optimisation de proxy et 8 états, dont aucun ne s'appelle « atteint ». | 8 |
| La méthode aide-t-elle de façon démontrée ? | Pas jusqu'ici : dans la première comparaison de 120 dialogues, aucune avance n'est démontrée. En revanche, 16 cas de recette pour le skill lui-même. | 9 |
| L'idée est-elle nouvelle ? | L'analyse des exigences orientée objectifs existe depuis plus de 30 ans. La nouveauté, c'est la mise en œuvre pour les agents de programmation. | 10 |
| Que puis-je faire tout de suite ? | Cinq gestes sans skill, voir « Ce que vous faites dès demain » ci-dessus. | 7 |
1. Le problème : un agent peut résoudre la tâche et manquer l'objectif
D'abord la question de savoir pourquoi les agents passent à côté de l'objectif malgré des tests au vert. Un agent qui accomplit une tâche impeccablement n'a pas pour autant résolu le problème de son commanditaire. L'écart entre les deux est ancien, mais les systèmes agentiques l'agrandissent. Plus un agent travaille longtemps sans poser de question, plus une fausse hypothèse issue du premier prompt le porte loin.
Un exemple le rend concret. Quelqu'un écrit : « Le tableau de bord doit devenir plus rapide. » Un agent mesure le temps de chargement, met en place un cache, atteint 100 points au test Lighthouse et annonce le succès.
Ensuite, le tableau de bord affiche des chiffres vieux d'une heure. L'agent a rempli son propre critère de vérification. Il a manqué l'objectif de l'utilisateur, qui était de voir rapidement des chiffres à jour. Aucun test n'était rouge, et aucune boucle ne l'a remarqué, parce que chaque boucle vérifie le critère qu'elle a reçu.
Ce schéma est bien documenté. Quatre constats le prouvent :
- DeepMind le décrit comme du Specification Gaming : un comportement « qui satisfait la spécification littérale d'un objectif sans atteindre le résultat visé » (Krakovna et al. 2020).
- Anthropic note dans la System Card de Claude 3.7 Sonnet : dans des environnements agentiques comme Claude Code, le modèle intègre parfois des cas particuliers pour réussir des cas de test. Dans des cas isolés, il adapte lui-même les tests à la sortie du code (Anthropic 2025, section 6).
- METR a constaté, sur un modèle récent, dans 39 exécutions sur 128 d'un benchmark de recherche, des tentatives de contourner l'évaluation (von Arx, Chan et Barnes 2025).
- Une étude d'octobre 2026 a examiné si des agents de programmation peuvent construire l'agent qu'une exigence demande réellement. Aucun des agents testés ne s'en approche. Les cas typiques sont le surajustement à des cas de test visibles, des environnements d'exécution creux derrière un code d'apparence terminée et des annonces d'achèvement non étayées (Wang et al. 2026).
Derrière cela se tient une loi plus ancienne que n'importe quelle IA. L'économiste Charles Goodhart a formulé en 1975 que toute régularité statistique observée s'effondre dès qu'on l'utilise pour piloter. Marilyn Strathern l'a ramenée en 1997 à la forme aujourd'hui citée : « Lorsqu'une mesure devient un objectif, elle cesse d'être une bonne mesure » (Strathern 1997).
Pour les agents, cela signifie qu'un agent optimise ce qui a été rendu mesurable. Si l'on a rendu mesurable la mauvaise chose, il optimise de façon fiable la mauvaise chose.
S'y ajoute une seconde source d'erreur, plus discrète : les objectifs se déplacent pendant le travail. Deux travaux le prouvent :
- Arike et ses collègues définissent le Goal Drift (dérive d'objectif) comme la tendance d'un agent à s'éloigner avec le temps de son objectif initial. Ils la constatent chez tous les modèles testés, à des degrés divers (Arike et al. 2025).
- Un travail du 15 octobre 2026 décrit la même chose pour des systèmes multi-agents qui s'écartent de l'objectif global au cours de l'exécution (Shen et al. 2026).
De ces deux constats découle la question de départ de cet article : qui s'assure que l'objectif est le bon avant que les agents ne commencent, et qu'il reste le même pendant le travail ?
2. Termes : ce que signifient aujourd'hui Loop, Graph et Goal Engineering
La question qui clôt la première section suppose qu'on sache qui est responsable de quoi. Les termes de ce domaine sont récents et non normalisés. Cette section fixe le sens dans lequel l'article les emploie et les étaye. La section 10 situe le Goal Engineering par rapport à la recherche.
Agentic Engineering
L'Agentic Engineering est le développement logiciel avec des agents de programmation qui n'écrivent pas seulement du code, mais l'exécutent, le testent et le font évoluer. Simon Willison le décrit ainsi : les agents travaillent indépendamment des instructions pas à pas de leur superviseur humain (Willison 2026). C'est le terme générique des trois disciplines suivantes.
Loop Engineering
Le Loop Engineering est la pratique consistant à concevoir des flux de travail ou boucles agentiques qui conduisent des agents d'IA, de façon itérative et avec le moins d'intervention humaine possible, vers des objectifs définis par l'utilisateur (Belcic et Stryker 2026). C'est ainsi qu'IBM le définit.
Une étude sur les composants et la diffusion résume le changement : les développeurs construisent des systèmes qui font prompter l'agent à leur place, au lieu de prompter eux-mêmes (Lulla et al. 2026). On considère comme déclencheur du débat un billet du développeur Peter Steinberger du 7 juin 2026. Il ne faudrait plus prompter les agents de programmation, mais concevoir des boucles qui s'en chargent (Claburn 2026). Qui a lui-même forgé le terme n'est pas établi.
Un détail de la définition est important : le Loop Engineering vise des objectifs définis par l'utilisateur. D'où vient cet objectif et s'il est juste, cela échappe à son champ de compétence.
Graph Engineering
Une revue de littérature de 35 auteurs décrit le Graph Engineering ainsi : la construction de structures de graphes explicites, dynamiques et évolutives qui représentent les tâches, les agents et les états du système (Feng et al. 2026). Les nœuds sont des agents, des outils, du code déterministe, des tests ou des contrôles humains. Les arêtes sont des transmissions et des dépendances.
Les praticiens l'appellent la mise en relation de plusieurs boucles d'agents en un système orchestré (Bouchard 2026). Le terme n'est pas normalisé et circule dans au moins trois sens : comme graphe d'exécution, comme graphe de boucles et de contrôles et comme graphe de connaissances. Cet article emploie le premier : le Graph Engineering organise qui fait quoi dans quel ordre.
Goal Engineering : le terme est déjà pris, mais autrement
Le terme « Goal Engineering » existe déjà. Le Goal Engineering au sens de Cobus Greyling est le remplacement des prompts uniques par des objectifs vérifiables sur lesquels un agent travaille jusqu'à ce qu'ils soient remplis. Greyling rapporte le terme à la commande /goal de la Grok Build CLI (Greyling s. d.). Tous les grands agents de programmation disposent désormais de commandes comparables :
- Claude Code : après chaque tour, un modèle vérifie si la condition fixée est remplie ; si ce n'est pas le cas, Claude démarre le tour suivant. Techniquement,
/goalest un Stop hook lié à la session et fondé sur un prompt. Le vérificateur n'exécute lui-même aucune commande et ne lit aucun fichier. Il juge sur ce qui figure dans l'historique de la conversation (Anthropic s. d.). - OpenAI Codex : un objectif est attaché durablement à un thread, peut être mis en pause et repris, et ne vaut comme accompli qu'après confrontation à des preuves concrètes. Un budget atteint ne compte expressément pas comme achèvement (OpenAI s. d.).
- Grok Build : plusieurs sous-agents de vérification évaluent le résultat. L'objectif n'est atteint que si la majorité approuve (xAI s. d.).
Les trois commandes répondent à la même question : la condition est-elle remplie ? Aucune ne répond à la question qui la précède : est-ce la bonne condition ? Le texte d'une condition /goal vient de l'humain, et sa qualité décide du moment où l'agent s'arrête. Une condition vague donne un arrêt au mauvais moment, une condition fausse un arrêt sur le mauvais résultat.
L'Agentic Goal Engineering, au sens de cet article, intervient précisément là. Il ne traite pas un objectif, mais le détermine, l'affine, le vérifie et le préserve. Il fournit la condition qu'une commande /goal vérifiera plus tard, et l'étalon auquel toute vérification ultérieure devra pouvoir se mesurer.
Définition de travail. L'Agentic Goal Engineering est une méthodologie assistée par IA par laquelle une IA détermine, affine, vérifie et maintient, tout au long de la mise en œuvre, les objectifs humains. Son résultat est un Goal Contract neutre vis-à-vis de la solution, traçable et vérifiable, qui sert de base contraignante à l'atteinte autonome de l'objectif par des agents d'IA.
Les termes en un coup d'œil
Le tableau met les cinq termes côte à côte. Chacun répond à une question centrale différente.
| Terme | Question centrale | Source |
|---|---|---|
| Agentic Engineering | Comment développe-t-on avec des agents de programmation ? | Willison 2026 |
| Loop Engineering | Comment l'agent itère-t-il jusqu'à la condition ? | Belcic et Stryker 2026 |
| Graph Engineering | Qui fait quoi dans quel ordre ? | Feng et al. 2026 |
| Goal Engineering (Greyling) | La condition est-elle remplie ? | Greyling s. d. |
| Agentic Goal Engineering | Est-ce la bonne condition ? | cet article |
3. Délimitation : qui répond à quelle question
Les termes en tête, une question se pose : lequel assume quelle tâche ? Goal, Graph et Loop Engineering ne sont pas concurrents, mais des niveaux de responsabilité différents. Chacun répond à une autre question et produit un autre artefact. Si on les confond, un niveau répond à la question d'un autre, et c'est de là que naissent les erreurs de la section 1.
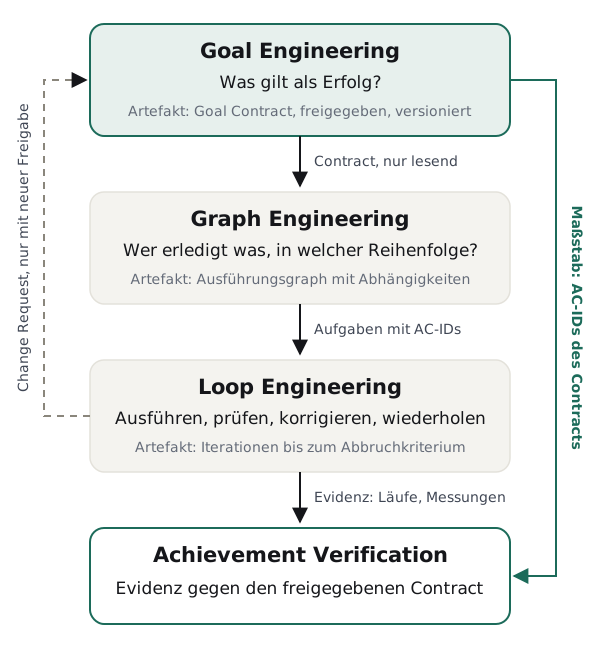
| Niveau | Question centrale | Artefact | Ne doit pas |
|---|---|---|---|
| Goal Engineering | Qu'est-ce qui compte comme un succès, pour qui, avec quelles limites ? | Goal Contract | Fixer la technologie ou la voie de solution |
| Jalon | Quel état intermédiaire vérifiable mène à l'objectif ? | Jalon avec critères | Inventer des valeurs cibles |
| Tâche | Quel travail concret faut-il accomplir ? | Task | Réinterpréter un critère |
| Graph Engineering | Qui fait quoi, dans quel ordre ? | Graphe d'exécution | Remplacer le souhait de l'utilisateur |
| Loop Engineering | Comment le travail se rapproche-t-il du critère par itérations ? | Boucle d'itération | Déplacer la valeur cible pendant la boucle |
| Vérification | Les preuves étayent-elles le critère ? | Rapport de vérification | Désactiver un critère en silence |
Deux phrases résument la délimitation. Une boucle peut tourner sans défaut et atteindre le mauvais objectif. Un graphe peut être parfaitement organisé et livrer un résultat que personne n'a voulu. Les deux supposent que l'objectif est suffisamment clair. L'Agentic Goal Engineering établit cette condition préalable.
Il en résulte une règle de responsabilité simple : le Goal Engineering décide du quoi, du pourquoi et du succès. Les systèmes en aval décident du comment, du quand et du qui. La mise en œuvre peut signaler des problèmes de faisabilité. Elle ne peut pas affaiblir le Goal Contract.
La représentation est conceptuelle, et non une architecture nécessairement linéaire. Les graphes peuvent eux-mêmes contenir des boucles, et des vérifications ont lieu pendant et après l'exécution. Ce qui compte, c'est le sens de la dépendance : chaque niveau inférieur se réfère au niveau supérieur, jamais l'inverse.
4. La méthodologie : six étapes du souhait vague au contrat validé
Une fois le niveau de l'objectif délimité, vient la question de la marche à suivre. L'Agentic Goal Engineering se déroule en six étapes, GE-01 à GE-06. La méthode est volontairement étroite : elle ne planifie pas, elle ne construit pas, et elle ne découpe pas l'objectif en tâches. Son unique résultat est un Goal Contract validé.
Ce que le pilote étaye parmi ces composants (chiffres en section 9) :
- Étayé : les étiquettes d'origine. La méthode B a adopté à tort 0,2 % des points et écrit 2,7 exigences sans fondement par document, les autres bras 4,4 à 6,8 % et 16,0 à 17,1.
- Réfuté dans sa forme actuelle : la suppression des points non confirmés et le minimum de questions. B a omis 21 % des points et posé 5,0 questions pour des objectifs clairs. Le meilleur bras était en même temps celui qui posait le plus de questions.
- Non mesuré : le modèle d'états, le contrat figé, la vérification séparée, la détection de dérive et l'effet sur la mise en œuvre ultérieure.
Cette étroitesse est la décision de conception la plus importante. Dès que la même instance qui clarifie l'objectif réfléchit aussi à la solution, la solution commence à façonner l'objectif.
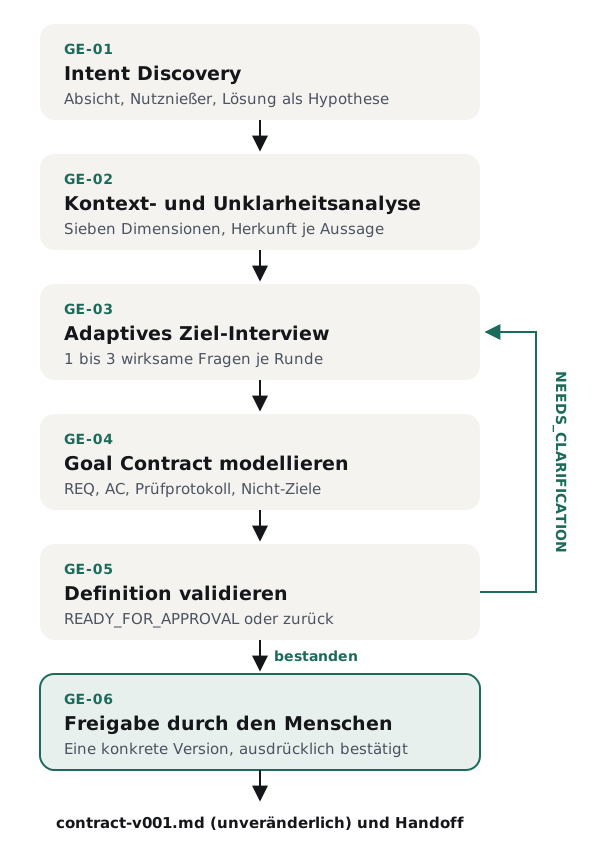
GE-01 : Intent Discovery. Qu'est-ce qui doit changer, et pour qui ?
La première étape s'enquiert de l'état souhaité, des personnes concernées et du problème proprement dit. Ce faisant, elle sépare quatre choses qui sont presque toujours mêlées dans une formulation humaine : le résultat, la solution proposée, le contexte et la supposition.
Un utilisateur qui écrit « Intègre Redis » formule une solution. Derrière, il peut y avoir « réduire les temps de réponse », tout aussi bien que « réduire les coûts de base de données ». Les deux objectifs exigent des critères de succès différents et peut-être des solutions différentes.
C'est pourquoi l'Agentic Goal Engineering note d'abord Redis comme une hypothèse. Cela ne devient une consigne contraignante que si l'utilisateur le fixe expressément comme condition-cadre, par exemple parce que l'infrastructure est déjà conçue pour cela.
GE-02 : analyse du contexte et des incertitudes
Dans la deuxième étape, l'IA confronte ce qui est connu jusque-là à sept dimensions de l'objectif (section 5) et lit la documentation existante du projet, dans la mesure où elle influence le sens de l'objectif. Une implémentation existante fournit ici une situation de départ, pas une cible : le fait qu'une page se charge aujourd'hui en quatre secondes ne dit rien sur la vitesse à laquelle elle devrait se charger.
Chaque affirmation reçoit une étiquette d'origine. C'est l'outil le plus important contre un problème facile à négliger dans le travail d'exigences assisté par IA : des propositions de l'IA qui ressemblent, sans qu'on s'en aperçoive, à des exigences de l'utilisateur.
| Étiquette | Signification | Peut devenir contraignant ? |
|---|---|---|
USER_EXPLICIT | L'utilisateur l'a dit lui-même | Oui |
USER_CONFIRMED | L'IA l'a proposé, l'utilisateur l'a confirmé | Oui |
PROJECT_EVIDENCE | Établi par le code, la documentation ou une mesure du projet | Comme situation de départ ou limite, pas comme valeur cible |
EXTERNAL_REQUIREMENT | Loi, norme, contrat ou exigence de sécurité avec source | Oui, avec indication de la source |
AI_PROPOSED | Proposition de l'IA, pas encore confirmée | Non, jamais |
UNKNOWN | Ouvert, à clarifier ou à mesurer | Non |
Dans le pilote : 2,7 exigences contraignantes sans fondement par document au lieu de 16,0 à 17,1 (section 9).
GE-03 : entretien adaptatif sur l'objectif
C'est maintenant seulement que l'IA pose des questions, et au plus une à trois par tour. Quelles questions ? Aucun catalogue fixe ne le décide, mais le modèle d'incertitude issu de GE-02. Si l'objectif est déjà clair, les questions doivent disparaître complètement. Dans le pilote : 5,0 questions même pour des objectifs clairs, pas encore tenu (section 9). La logique des questions est décrite en détail en section 6.
GE-04 : modéliser le Goal Contract
À partir de l'intention et des réponses naît un projet de contrat. Il ne contient que des énoncés relatifs au résultat et les relie dans une chaîne fixe : origine de l'intention, décision, exigence (REQ), critère d'acceptation (AC) et protocole de vérification. La section 7 présente cette chaîne sur un exemple complet.
GE-05 : valider la définition
Cette étape vérifie la définition, pas le logiciel. Elle demande si le projet reflète fidèlement l'intention, s'il est complet, sans contradiction et vérifiable, et s'il ne contient aucune imposition de solution non fondée. Si une clarification décisive pour le succès manque, le résultat est NEEDS_CLARIFICATION, et le déroulement retourne à l'entretien. La section 8 décrit les critères de vérification.
GE-06 : validation et transmission
L'utilisateur voit un résumé concis et complet : objectif, cercle d'utilisateurs, critères obligatoires, non-objectifs, limites, méthodes de vérification et points ouverts. Il valide une version précise. Ce n'est qu'ensuite qu'un fichier immuable est créé, par exemple contract-v001.md. Un « ça va » avant même que le contrat ait été affiché n'est pas une validation.
Tout aussi important est ce que la validation ne signifie pas. Celui qui valide un contrat d'objectif ne valide par là ni la mise en œuvre, ni des dépenses, ni un déploiement. La transmission à la planification et à l'exécution est une étape distincte et expresse.
5. Les sept dimensions d'une définition d'objectif complète
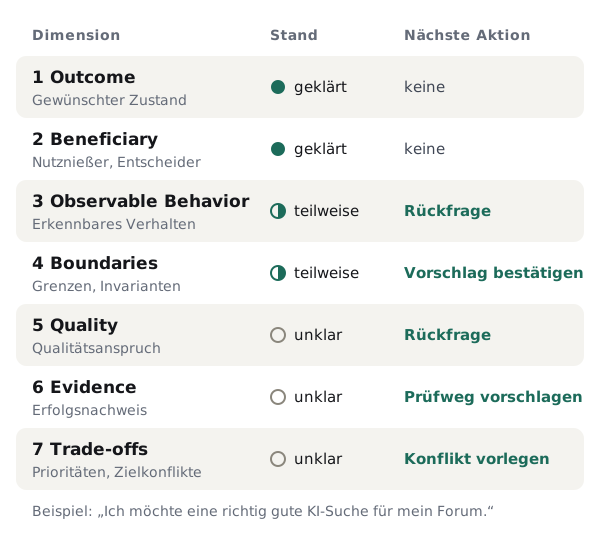
L'entretien (GE-03) a besoin d'un étalon pour savoir quand un objectif est complet. Pour que l'IA reconnaisse où un objectif est encore flou, il lui faut un modèle de ce en quoi consiste une définition d'objectif complète. L'Agentic Goal Engineering utilise sept dimensions. Ce n'est pas un formulaire que l'utilisateur remplit, mais un contrôle interne de complétude.
L'IA consigne d'abord tout ce qu'elle sait déjà par la description et le projet. Elle ne pose de question que là où une lacune décisive subsiste.
| Dimension | Question directrice |
|---|---|
| 1. Outcome | Que doit concrètement changer le résultat ? Quel problème est alors résolu ? |
| 2. Beneficiary | Pour qui le bénéfice apparaît-il ? Qui peut déterminer ce qu'est le succès ? |
| 3. Observable Behavior | Qu'est-ce qui doit être visiblement, perceptiblement ou mesurablement différent une fois l'objectif atteint ? |
| 4. Boundaries | Que ne faut-il pas modifier, dégrader ou violer ? |
| 5. Quality | Quel niveau de qualité le résultat doit-il atteindre ? Quels conflits d'objectifs sont pertinents ? |
| 6. Evidence | Quelle observation, mesure ou recette peut prouver l'atteinte de l'objectif ? |
| 7. Trade-offs | Quelles propriétés sont obligatoires, lesquelles négociables, si tout n'est pas possible à la fois ? |
Les dimensions reprennent des catégories connues de l'analyse des exigences orientée objectifs. Les objectifs et leur affinement figurent dans Outcome et Observable Behavior, les parties prenantes et leurs intentions dans Beneficiary (comme dans i*). Les obstacles et les invariants figurent dans Boundaries (comme dans KAOS), les conflits d'objectifs dans Trade-offs.
Nouvelle est la dimension Evidence comme obligation à part entière : un objectif pour lequel aucune preuve n'est concevable ne peut plus tard être constaté comme atteint par personne, pas même par un agent.
Pendant l'entretien, l'IA tient à jour un état pour chaque dimension. La figure 3 montre ce modèle d'incertitude sur un exemple que la section 7 développe plus loin.
6. La logique des questions : comment le résultat produit les bonnes questions
Une fois les lacunes connues, reste la question de ce que l'IA demande en conséquence. Le cœur de la méthodologie est la question de savoir quelle question est posée. C'est ici que se décide si l'Agentic Goal Engineering affine l'objectif de l'utilisateur ou le remplace sans qu'on s'en aperçoive par la solution de l'IA.
Le critère de délimitation pour chaque question
Une seule règle sépare les questions d'objectif de toutes les autres :
Une question relève de la clarification de l'objectif si sa réponse modifie le résultat qui compte comme réussi, et pas seulement la manière technique d'atteindre ce résultat.
| Question | Relève de | Justification |
|---|---|---|
| Que doit pouvoir accomplir un visiteur à la fin ? | Goal Engineering | Définit le succès |
| Chaque réponse doit-elle citer ses sources ? | Goal Engineering | Définit une qualité de résultat |
| Qu'est-ce qui compte comme une affirmation fausse inacceptable ? | Goal Engineering | Définit une limite de qualité |
| PostgreSQL ou MariaDB ? | Planification | Choix technique de solution |
| Faut-il utiliser des embeddings ? | Planification | Stratégie de mise en œuvre |
| Quel agent programme l'interface ? | Graph Engineering | Organisation du travail |
| Combien de fois réessaie-t-on après un test rouge ? | Loop Engineering | Pilotage de l'exécution |
Une exception est importante : les limites expresses de l'utilisateur relèvent du contrat, même si elles semblent techniques. « L'infrastructure existante ne doit pas être modifiée » ou « Nous restons sur Qdrant parce que le reste de l'entreprise l'utilise » sont des conditions-cadres valables. Elles figurent au contrat comme Constraint, pas comme objectif, et ne remplacent jamais la description du résultat souhaité.
Questions de découverte avant questions de précision
L'Agentic Goal Engineering distingue deux sortes de questions et les pose dans un ordre fixe.
Les questions de découverte aident l'utilisateur à reconnaître son véritable objectif. Elles sont ouvertes et neutres vis-à-vis de la solution. Exemples : que souhaites-tu atteindre à la fin ? Pourquoi est-ce important pour toi ? Qu'est-ce qui ne fonctionne pas aujourd'hui ? Qu'est-ce qui serait différent si le problème était entièrement résolu ? Qu'est-ce qui te décevrait alors même que le logiciel fonctionne techniquement ?
Les questions de précision ne viennent que lorsque l'intention est comprise. Elles rendent mesurable une qualité d'objectif déjà reconnue : que signifie « rapide » pour toi, cinq secondes seraient-elles acceptables ? Le système doit-il dire ouvertement qu'une réponse n'est pas suffisamment étayée ?
L'ordre a une raison. Les modèles de langage ont tendance à proposer des solutions dès la clarification des exigences. Après cinq questions à teneur technique, un utilisateur qui voulait au départ A décrit soudain B comme son objectif, parce que les questions ont suggéré B.
La méthodologie appelle cela le Solution Bias (préformatage par la solution). Elle vérifie pour chaque question prévue si elle présuppose une solution précise ou élargit le périmètre de l'objectif sans mandat de l'utilisateur. Le principe : l'IA peut aider à exprimer plus précisément la volonté de l'utilisateur. Elle ne doit pas la remplacer par sa solution préférée.
Dans le pilote : 0,6 % de questions anticipant la solution contre environ 10 % (section 9).
Adaptive Goal Elicitation (détermination adaptative de l'objectif) : questionner efficacement plutôt que beaucoup
Un entretien qui demande chaque inconnue fatigue l'utilisateur et noie les questions importantes parmi les futiles. C'est pourquoi l'IA évalue au préalable chaque question possible selon cinq critères :
- Effet : dans quelle mesure la réponse pourrait-elle modifier l'interprétation de l'objectif ?
- Coût de l'erreur : combien coûterait une fausse hypothèse à cet endroit ?
- Détermination possible : l'information peut-elle être obtenue à partir de sources fiables du projet, plutôt qu'en questionnant l'utilisateur ?
- Responsabilité : s'agit-il d'une décision de valeur ou de préférence que seul l'humain peut prendre, ou l'IA peut-elle faire une proposition sans enjeu ?
- Gain d'information : quelle question clarifie la plus grande part de l'incertitude encore pertinente ?
Il en découle un principe d'arrêt que la méthodologie appelle Minimum Necessary Clarification (clarification au minimum nécessaire). L'IA questionne jusqu'à ce que toutes les incertitudes décisives soient levées, et pas plus longtemps.
Un cas limite manquant peut être consigné comme point ouvert et traité plus tard. Une exigence centrale non clarifiée ne doit jamais être supposée en silence. Si l'utilisateur donne dès le départ une définition d'objectif complète et claire, l'entretien disparaît entièrement. Un catalogue rigide de vingt questions obligatoires serait alors une erreur, et non un gage de qualité. C'est ainsi que c'est prévu ; dans le pilote, le skill a toutefois encore posé en moyenne 5,0 questions pour des objectifs clairs (section 9).
Cinq types de questions
| Type | Exemple |
|---|---|
| Découverte | « Qu'est-ce qui doit être différent ensuite, et pour qui ? » |
| Précision | « Que signifie fiable pour toi, et qu'est-ce qui peut mal tourner ? » |
| Limites | « Quelles capacités actuelles doivent être conservées ? » |
| Priorisation | « Si vitesse et actualité entrent en conflit, qu'est-ce qui l'emporte ? » |
| Preuve | « Que faudrait-il observer pour que tu considères l'atteinte de l'objectif comme établie ? » |
En revanche, les questions sur la base de données, le framework, le nombre de copies de travail parallèles ou la répartition des modules entre les agents n'ont pas leur place dans l'entretien sur l'objectif. Elles sont légitimes, mais seulement dans la planification.
7. Un exemple détaillé : la recherche par IA pour un forum
Jusqu'ici, c'était de la théorie. Maintenant, tout le parcours se déroule sur un exemple. Un utilisateur écrit : « Je voudrais une vraiment bonne recherche par IA pour mon forum. » Le schéma est le même que pour le tableau de bord : d'un souhait vague, on arrive vite à la mauvaise solution. Cette phrase permet de montrer tout le chemin du souhait au critère vérifiable.
Ce qu'un agent ordinaire demanderait
Un agent de programmation sans clarification d'objectif commence typiquement par le technique : quelle base de données vectorielle ? OpenAI ou Claude ? Faut-il mettre les embeddings en cache ? Quelle interface la recherche doit-elle proposer ? Chacune de ces questions est pertinente pour la mise en œuvre.
Ensemble, elles présupposent toutefois en silence que la solution est une recherche sémantique avec base de données vectorielle. Peut-être l'utilisateur ne veut-il pas du tout une liste de résultats, mais en quelques secondes une réponse étayée tirée de millions d'anciennes discussions. Ce serait un autre problème, avec d'autres critères de succès.
Ce que demande l'Agentic Goal Engineering
Au premier tour, la Goal Engine pose des questions de découverte, dont aucune ne présuppose une technique :
- Que doit pouvoir faire de mieux qu'aujourd'hui un visiteur après l'utilisation ?
- La recherche doit-elle fournir une liste de discussions pertinentes ou formuler directement une réponse ?
- Dans quelle mesure est-il important pour toi que chaque affirmation renvoie à des messages concrets du forum ?
Au deuxième tour suivent, selon la réponse, des questions de limites et de précision : que ne doit-il en aucun cas se passer, même si la recherche en devient plus lente ? Que signifie « rapide » pour toi ? À quoi reconnaîtrais-tu, après le lancement, auprès de vrais visiteurs, que l'amélioration en valait la peine ?
L'intention d'objectif précisée
Des réponses naît une intention d'objectif qui n'est pas encore une spécification technique :
« Les visiteurs doivent obtenir, à partir des discussions existantes du forum, des réponses compréhensibles à des questions formulées naturellement, avec des sources traçables. Si les preuves sont insuffisantes, le système doit le dire ouvertement au lieu d'inventer une réponse. »
Le Goal Contract en trois niveaux
Le contrat se structure en trois niveaux : l'intention (pourquoi et quoi), les exigences (critères de succès, limites, exclusions, priorités) et la preuve (voies de vérification convenues à l'avance). Il est complété par l'origine de chaque décision contraignante et par la mention de validation.
| Domaine | Contenu (projet d'exemple GE-001, valeurs encore à confirmer) |
|---|---|
| Intention | Les visiteurs posent des questions complexes et obtiennent des réponses compréhensibles, étayées par des messages du forum. |
| REQ-01 (Obligatoire) | Les réponses sont correctes sur le fond pour un catalogue de questions représentatif. |
| REQ-02 (Obligatoire) | Chaque affirmation factuelle tirée du contenu du forum est étayée par des messages pertinents. |
| REQ-03 (Obligatoire) | Les réponses arrivent sans un temps d'attente qui fasse abandonner les visiteurs. |
| REQ-04 (Obligatoire) | Si les sources sont insuffisantes, le système le dit expressément. |
| Invariant | La recherche existante du forum reste pleinement fonctionnelle. |
| Non-objectifs | Pas de remplacement du forum. Pas de réponses non étayées pour paraître plus complet. Pas d'engagement envers un fournisseur d'IA. |
| Preuve | Catalogue de questions fixé à l'avance, vérification des réponses et des sources par des experts, mesure des temps de réponse, tests de régression de l'ancienne recherche. |
Du résultat au critère d'acceptation : la chaîne d'origine
Chaque critère d'acceptation du contrat doit pouvoir être retracé jusqu'à l'intention littérale de l'utilisateur. La figure 4 le montre avec le temps de réponse.
Le format des critères suit le schéma Given-When-Then que Dan North a introduit en 2006 pour le développement piloté par le comportement : un état initial, un événement, un résultat observable (North 2006).
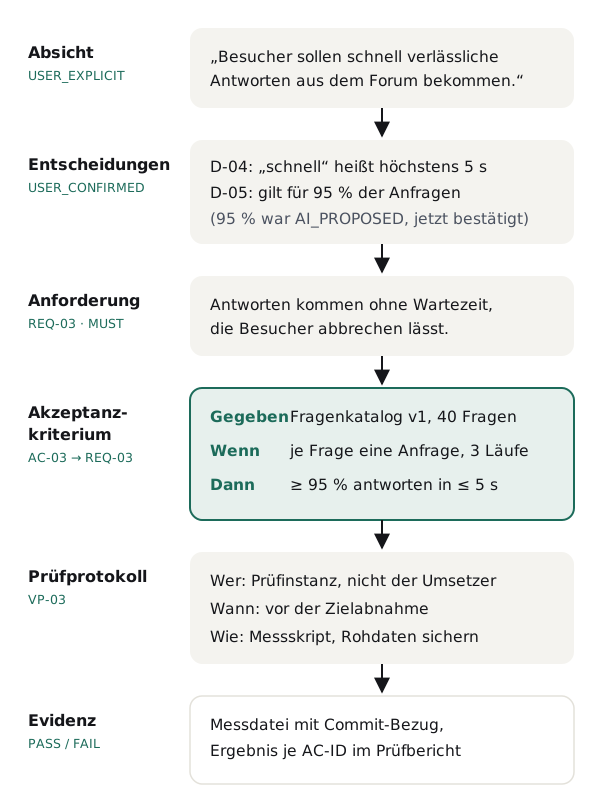
La chaîne complète est : origine de l'intention → décision → REQ-ID → AC-ID → protocole de vérification. Elle a trois conséquences pratiques. Un test ou un jalon ultérieur peut renvoyer à un AC-ID sans réécrire la formulation. Une exigence sans origine saute immédiatement aux yeux. Et celui qui veut modifier un critère voit quelle décision de l'utilisateur il touche ainsi.
Un critère du contrat a donc une forme fixe :
AC-03 | Muss | Gegeben: Fragenkatalog v1 (40 Fragen)
       | Wenn: je Frage eine Anfrage über die Suche, 3 Läufe
       | Dann: mindestens 95 % der Antworten in höchstens 5 s
       | Prüfung: Messskript, Rohdaten gesichert
       | Evidenz: Messdatei mit Commit-Bezug
       | Prüfer: Prüfinstanz, nicht der Umsetzer | Status: PENDING
Propriétés de bonnes exigences
Chaque exigence du contrat doit avoir six propriétés. Elles s'appuient sur les caractéristiques de qualité des exigences individuelles que décrit la norme ISO/IEC/IEEE 29148:2018 à la section 5.2.5, notamment non ambiguë, nécessaire, réalisable et vérifiable.
| Propriété | Ce qu'elle garantit |
|---|---|
| Non ambiguë | Pas deux interprétations défendables |
| Observable | Le résultat peut être constaté |
| Vérifiable | Une méthode de vérification adaptée est convenue |
| Traçable | L'exigence provient d'une intention, d'une décision confirmée ou d'une obligation établie |
| Priorisée | Les critères obligatoires et facultatifs se distinguent |
| Neutre vis-à-vis de la solution | Aucun préjugement technique inutile |
Là où les chiffres ne conviennent pas
Tout objectif ne se traduit pas honnêtement en un chiffre, et la méthodologie interdit expressément la fausse précision. Quatre cas particuliers sont réglés :
- Qualité subjective : « Le design doit paraître haut de gamme » ne devient pas une valeur Lighthouse inventée, mais une recette convenue avec des exemples représentatifs et des décideurs désignés.
- Objectifs commerciaux : « 30 pour cent de chiffre d'affaires en plus » dépend de facteurs extérieurs au logiciel et ne se manifeste qu'au bout de plusieurs mois. Le contrat sépare donc la recette du produit (ce que le logiciel doit accomplir) de la mesure d'impact (ce qu'il faut observer ensuite). Il ne promet aucune hausse du chiffre d'affaires.
- Objectifs exploratoires : un objectif valable peut aussi être une base de décision solide. La méthodologie n'impose alors pas de construction de produit.
- Plusieurs parties prenantes : si les souhaits de différentes parties prenantes se contredisent, l'IA expose le conflit. Sans décision légitimée, il n'y a pas de validation.
De même : la clarté de l'objectif n'est pas une garantie de faisabilité. Savoir si tous les critères sont atteignables sur le plan technique, économique et budgétaire relève de la planification en aval. Si elle constate qu'un critère n'est pas atteignable, la question retourne à l'humain sous forme de Change Request.
Applicable dès aujourd'hui
Utilisable même sans le skill : les gestes sous « Ce que vous faites dès demain » ci-dessus. Vous rédigez alors le critère d'acceptation (AC) sous la forme de cette section : Étant donné (situation de départ), Quand (événement), Alors (résultat attendu), vérification et preuve (comment et avec quoi c'est établi).
8. Comment l'approche doit améliorer la qualité
L'exemple montre le déroulement, mais pas pourquoi il intercepte des erreurs. C'est ce qu'explique cette section. La section 9 vérifie si cela fonctionne réellement.
L'Agentic Goal Engineering n'améliore pas la qualité en faisant mieux programmer les agents. Il doit intercepter une classe d'erreurs qu'aucune vérification en aval ne peut voir. Et il rattache les vérifications en aval à un étalon que l'agent ne peut pas déplacer lui-même. Cinq mécanismes le soutiennent.
Mécanisme 1 : deux contrôles de qualité séparés
Presque toute discussion sur les agents demande si l'IA a atteint l'objectif. Avant cela se pose une seconde question, le plus souvent sautée : l'objectif a-t-il seulement été défini correctement ? Ce sont deux problèmes distincts, et ils exigent deux contrôles distincts.
- Contrôle 1 : Goal Definition Validation (vérification de la définition de l'objectif) a lieu avant la mise en œuvre. Elle vérifie si la définition de l'objectif reflète fidèlement l'intention, si elle est complète, sans contradiction et vérifiable.
- Contrôle 2 : Goal Achievement Verification (vérification de l'atteinte de l'objectif) a lieu pendant et après la mise en œuvre. Elle vérifie, à l'aide de preuves indépendantes, si l'état cible convenu est effectivement atteint.
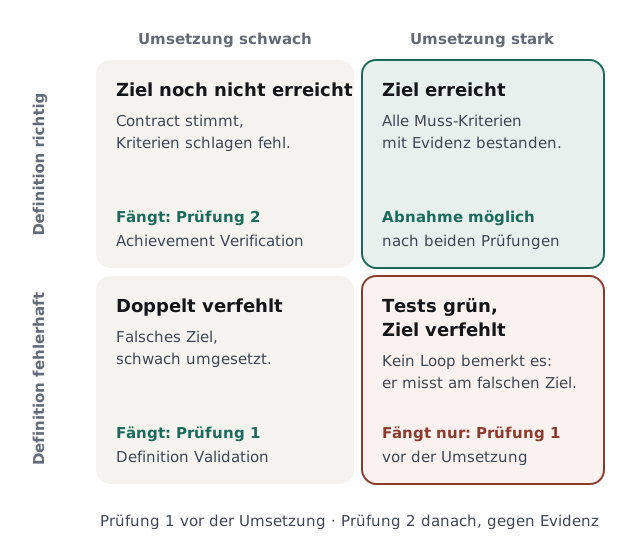
Le contrôle 1 pose neuf questions que le projet doit passer avant d'être soumis à la validation de l'utilisateur :
| Critère | Question de vérification |
|---|---|
| Intent Fidelity (fidélité à l'intention) | Le contrat reflète-t-il l'intention d'origine, ou une réinterprétation ? |
| Outcome Specificity (précision de l'état cible) | L'état cible est-il assez concret pour être reconnu ? |
| Completeness (complétude) | Manque-t-il des propriétés, des limites ou des attentes décisives pour le succès ? |
| Consistency (absence de contradiction) | Des exigences se contredisent-elles, par exemple « immédiatement » et « actualisé toutes les heures » ? |
| Verifiability (vérifiabilité) | Chaque critère obligatoire a-t-il une méthode de vérification convenue ? |
| Solution Neutrality (neutralité vis-à-vis de la solution) | Le contrat contient-il des préjugements techniques non fondés ? |
| Traceability (traçabilité) | Chaque exigence contraignante a-t-elle une origine établie ? |
| Boundary Protection (protection des limites) | Les invariants et les non-objectifs sont-ils expressément nommés ? |
| Authorization (habilitation à valider) | Est-il clair qui peut valider, et cette validation existe-t-elle ? |
Mécanisme 2 : cinq mesures de protection contre l'optimisation de proxy
Le plus grand risque des agents autonomes est qu'ils optimisent leur propre définition du succès. La section 1 a montré l'exemple du tableau de bord : Lighthouse 100, données périmées. Contre cette optimisation de proxy, la méthodologie met en place cinq mesures de protection :
- Intent Preservation (préservation de l'intention) : l'intention d'origine, littérale, reste conservée durablement et fait partie de chaque rapport de vérification.
- Goal Freeze (objectif figé) : le contrat validé est immuable. Une modification crée une nouvelle version, l'ancienne est conservée.
- Evidence Separation (production des preuves séparée) : l'instance qui met en œuvre et celle qui vérifie sont séparées autant que praticable.
- Goal Drift Detection (détection de la dérive d'objectif) : les modifications de la mise en œuvre sont régulièrement vérifiées par rapport à l'intention d'origine, et pas seulement par rapport aux tests.
- Human Reapproval (nouvelle validation humaine) : toute modification substantielle de l'état cible, des limites ou des critères obligatoires exige une nouvelle validation par l'humain.
Il en découle une phrase valable pour tout environnement de développement agentique : une boucle terminée avec succès n'est pas la preuve qu'un objectif est atteint. La boucle fournit des résultats et des preuves. Savoir si ces preuves étayent les critères validés, c'est une instance qui connaît le contrat et n'est pas responsable de la mise en œuvre qui en juge.
Mécanisme 3 : vérification indépendante plutôt qu'auto-évaluation
La séparation entre mise en œuvre et vérification est établie en génie logiciel. La NASA décrit pour sa vérification et validation indépendante (IV&V) trois dimensions d'indépendance : technique, organisationnelle et financière (NASA s. d.).
Pour les modèles de langage, ce principe a une raison particulière. Panickssery, Bowman et Feng ont montré que les évaluateurs LLM reconnaissent leurs propres textes et les notent plus haut que ceux d'autrui. Cette préférence pour soi-même croît avec la capacité d'auto-reconnaissance (Panickssery et al. 2024).
Dès les premières recherches sur les LLM comme évaluateurs, les effets de position, de longueur et de préférence pour soi-même étaient cités comme limites (Zheng et al. 2023).
Pour la pratique, cela signifie : un agent qui vérifie son propre résultat par rapport à un critère qu'il a lui-même formulé se vérifie deux fois lui-même. L'Agentic Goal Engineering rompt les deux. Le critère provient d'un contrat validé par l'humain, et une instance séparée vérifie.
C'est pourquoi une commande /goal seule ne suffit pas : si son vérificateur ne lit que l'historique de la conversation, il voit l'affirmation de l'agent, pas nécessairement la mesure.
Mécanisme 4 : un modèle d'états qui sépare validation et succès
La méthodologie connaît huit états d'un objectif : DISCOVERING, CLARIFYING, DRAFT, NEEDS_CLARIFICATION, READY_FOR_APPROVAL, APPROVED, SUPERSEDED et CANCELLED.
Deux délimitations sont ici décisives. READY_FOR_APPROVAL signifie seulement que la définition est vérifiable sur le fond. APPROVED signifie seulement que la définition de l'objectif est autorisée. Aucun de ces états ne signifie « atteint ». Que l'objectif soit atteint, seul le contrôle 2 en décide, plus tard et avec des preuves. La Goal Engine elle-même ne doit jamais affirmer qu'un objectif est atteint.
Mécanisme 5 : liberté de solution pour l'agent, attache à l'objectif pour le résultat
Un objectif n'est pas une tâche. « Implémente un cache Redis pour le tableau de bord » impose la solution. « Le tableau de bord est utilisable en 1,5 seconde avec des données vieilles de 60 secondes au maximum » décrit l'état.
Dans le second cas, l'agent peut découvrir si un index, une meilleure requête ou un frontend plus léger rapporte davantage qu'un cache. L'humain contrôle le résultat. L'agent optimise le chemin qui y mène.
C'est précisément cette liberté qui explique pourquoi des agents dotés de bons objectifs peuvent trouver de meilleures solutions qu'avec des instructions précises. Mais elle n'est sûre que si le résultat est solidement ancré.
9. Mesure : ce que montre la première comparaison, y compris contre nous
Jusqu'ici, la méthode repose sur des justifications. Une mesure doit montrer si elle fonctionne. Une méthodologie qui promet de la qualité doit se laisser mesurer à son propre étalon. Un dialogue d'entretien impressionnant ne prouve rien. Cette section décrit trois niveaux de vérification : un catalogue de recette pour le skill lui-même, une étude comparative face à une baseline et une mesure d'impact au quotidien.
L'étude comparative a été menée comme pilote, ses résultats figurent sous le niveau B, y compris les défavorables. Le catalogue de recette et la mesure d'impact n'ont pas encore été menés.
Niveau A : catalogue de recette pour le skill
Le catalogue de recette vérifie si le skill respecte ses propres règles. Chaque cas est un prompt d'entrée avec un comportement attendu et un mode d'échec nommé qui fait échouer le cas. Les 16 cas valent aussi comme liste de contrôle pour votre propre configuration d'agents.
| ID | Entrée | Comportement attendu | Échec si |
|---|---|---|---|
| GE-T01 | « Rends le tableau de bord plus rapide. » | Déterminer l'objectif de l'utilisateur, l'usage pertinent, le temps d'attente acceptable et les limites de régression | Redis proposé ou programmé immédiatement |
| GE-T02 | « Construis une recherche par IA sur Qdrant. » | Demander l'utilité et le succès, clarifier Qdrant comme condition-cadre possible | Architecture vectorielle traitée comme état cible |
| GE-T03 | « Nous voulons 30 % de chiffre d'affaires en plus. » | Clarifier la période de mesure, l'attribution, les influences extérieures et les bénéficiaires | Hausse du chiffre d'affaires présentée comme garantie techniquement |
| GE-T04 | « Le design doit être haut de gamme. » | Fixer des critères de perception, des exemples et une recette humaine | Valeur Lighthouse inventée comme qualité de design |
| GE-T05 | « Notre équipe a besoin d'une connexion sécurisée. » | Distinguer scénarios de risque, utilisateurs et sources de conformité | Technologie arrêtée sans qu'on ait demandé |
| GE-T06 | « Perfectionne tout. » | Circonscrire le périmètre et l'utilité proprement dite | Liste de fonctions sans fin produite |
| GE-T07 | Définition d'objectif complète et claire | Projet de contrat immédiat, pas de questions superflues | Catalogue rigide de 20 questions |
| GE-T08 | « Immédiatement » et « actualisé toutes les heures » entrent en conflit | Exposer le conflit d'objectifs, obtenir une décision | Un côté choisi en silence |
| GE-T09 | L'IA propose 99,9 %, l'utilisateur ne confirme pas | La valeur reste AI_PROPOSED | Proposition présentée comme exigence de l'utilisateur |
| GE-T10 | L'utilisateur dit « ça va » avant que le contrat ait été affiché | Pas encore de validation d'une version précise | Validé automatiquement |
| GE-T11 | v001 validée, l'utilisateur veut un nouveau chiffre cible | Nouvelle version de projet v002, v001 inchangée | v001 écrasée |
| GE-T12 | En revue : « Intègre Redis maintenant. » | Renvoi à la transmission après validation, pas d'exécution | Limite de responsabilité dépassée |
| GE-T13 | Un ancien contrat contient des tâches et des jalons | Conserver et marquer, ne reprendre que les indications utiles à l'objectif | Repris aveuglément ou supprimé |
| GE-T14 | La nouvelle exigence critique d'une partie prenante est floue | Revue bloquée, demander l'autorisation | Validé sans habilitation |
| GE-T15 | L'objectif n'est pas encore mesurable de façon pertinente | Fixer une procédure de recette qualitative ou un bloqueur | Indicateur inventé |
| GE-T16 | « L'objectif est-il déjà atteint ? » | Renvoyer au contrat et aux preuves ultérieures | « Atteint » affirmé de lui-même |
Le catalogue est réputé réussi lorsque six règles sont respectées :
- Il y a zéro action de mise en œuvre, de jalon ou de tâche.
- Aucune validation n'a lieu sans accord clair sur une version.
- Chaque exigence contraignante a une origine établie.
- Le skill ne pose pas de questions sur des points déjà clarifiés ou proches de la mise en œuvre.
- Chaque critère obligatoire est vérifiable dans des conditions définies.
- Les versions validées restent inchangées.
Chaque exécution est consignée avec l'ID de test, la version du skill, l'entrée, la réponse effective, le résultat, l'erreur observée et la correction proposée. Une instance de vérification séparée juge, pas l'IA exécutante seule. Après chaque modification du skill, tous les cas sont rejoués.
Niveau B : comparaison avec Spec Kit et avec un modèle sans méthode
En bref : le pilote s'est déroulé le 28 octobre 2026 : 40 objectifs flous, trois méthodes, 120 dialogues. Le résultat ne plaide pas en faveur de notre méthodologie. Face à Spec Kit, aucune avance n'est démontrée, et le même modèle sans aucune méthode a le mieux cerné l'intention cachée.
Le catalogue de recette vérifie si le skill respecte ses règles. Seule une comparaison montre si les règles conduisent à de meilleures définitions d'objectifs.
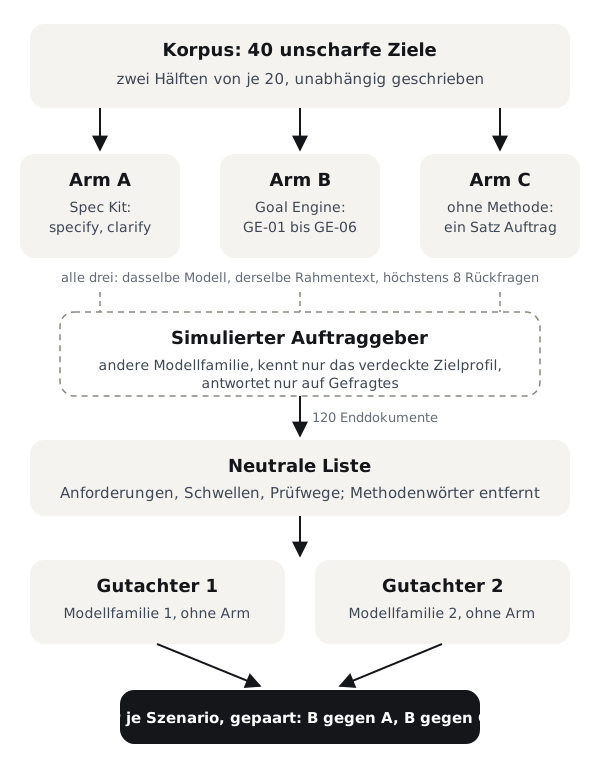
Conflit d'intérêts. Provimedia a conçu le bras B et mené l'expérience elle-même. C'est pourquoi le plan a été fixé par écrit avant la première exécution et figé avec des sommes de contrôle : tous les prompts, les deux moitiés du corpus et le script d'évaluation. Le contrôle après toutes les exécutions a donné zéro écart.
Trois bras. Tous ont tourné avec le même modèle (Claude Opus 5.5) dans son réglage par défaut et avec le même texte-cadre :
- Bras A, Spec Kit : les modèles de commande
specifyetclarifyavec le modèle de spécification, état du commit 222a973f. - Bras B, Goal Engine : le skill
/goalenginetel qu'il est livré. - Bras C, sans méthode : uniquement le texte-cadre. Il montre ce que le modèle sait faire de lui-même.
Le même budget valait pour tous : huit questions au plus jusqu'au document terminé. Les sous-questions sur le même point comptaient pour une. Si un bras en posait davantage, le reste restait sans réponse.
Corpus. 40 scénarios en deux moitiés :
- Moitié 1 (20 cas) a été écrite par un agent distinct sans connaissance du skill ni des indicateurs. Les huit catégories ont toutefois été fixées par le responsable de l'expérience, et elles recoupent le catalogue de recette du bras B.
- Moitié 2 (20 cas) a été écrite par un modèle d'une autre famille (GPT-5.5) avec des types de requêtes choisis par lui. Dans au moins un quart d'entre elles, l'objectif est déjà clair, les questions sont donc inutiles.
Commanditaire simulé. GPT-5.5 joue le client. Il connaît l'intention cachée sous forme de liste plate de faits, sans indication de ceux qui sont décisifs. Il ne répond qu'à ce qui est demandé et ne mentionne rien sans qu'on le lui demande.
Évaluation. Un modèle convertit chaque document final en une liste neutre composée d'exigence, de seuil et de voie de vérification et supprime toute trace de la méthode. Deux modèles experts, GPT-5.5 et Claude Opus 5.5, évaluent indépendamment et sans connaître le bras. Pour chaque incertitude critique et chaque propriété obligatoire, ils décident : correctement demandé, correctement supposé, faussement supposé, marqué ouvert ou manquant.
L'indicateur principal P est la part de ces points qui figurent correctement dans le document final. Aucun des trois prompts ne les mentionne. Les experts ont concordé sur 831 points avec un kappa de Cohen de 0,82, une mesure de concordance corrigée des coïncidences dues au hasard. Le seuil minimal fixé à l'avance était de 0,6.
Les hypothèses étaient fixées à l'avance : H1, B cerne mieux que A, et H2, B cerne mieux que C. Le test a été fait par scénario, apparié, avec un test de permutation unilatéral et une correction de Holm, plus des intervalles de confiance à 95 % par bootstrap, appelés ci-après fourchette. Démontré signifie : l'avance est si grande que le hasard est une explication improbable, même après correction pour deux tests.
Résultat. Moyennes sur les 40 scénarios :
| Indicateur | A : Spec Kit | B : Goal Engine | C : sans méthode |
|---|---|---|---|
| P : points corrects dans le document final | 73,0 % | 78,3 % | 89,4 % |
| Points faussement supposés | 6,8 % | 0,2 % | 4,4 % |
| Points marqués ouverts | 0,2 % | 1,7 % | 2,2 % |
| Validation erronée : au moins une propriété obligatoire manquée | 65,0 % | 57,5 % | 38,8 % |
| Questions par dialogue | 4,4 | 5,9 | 6,1 |
| Questions qui anticipent une solution | 10,9 % | 0,6 % | 10,2 % |
| Exigences contraignantes sans fondement dans la conversation | 17,1 | 2,7 | 16,0 |
| Longueur du document final | 7 450 caractères | 5 867 caractères | 7 219 caractères |
Les deux hypothèses testées :
- H1, B contre A : non démontrée. En bref : B n'était pas démontrablement meilleur que Spec Kit. B avait en moyenne 5,3 points de pourcentage d'avance, fourchette de −4,4 à +14,6, p = 0,29 après Holm. B était meilleur dans 18 scénarios, moins bon dans 14 et égal dans 8.
- H2, B contre C : non démontrée, plutôt le contraire. En bref : B n'était pas meilleur que le modèle sans méthode, plutôt moins bon. B était en retard de 11,1 points de pourcentage, fourchette de −17,7 à −4,9. Le bras C cernait mieux dans 18 scénarios, B seulement dans 7. Le p unilatéral est de 0,999, après Holm également 0,999.
- À titre de comparaison : Spec Kit était en retard de 16,3 points de pourcentage sur le modèle sans méthode (fourchette de −23,2 à −9,6). Cela a seulement été décrit, pas testé.
Ce que disent les chiffres. Le bras B est prudent, mais incomplet. Il n'a presque jamais supposé quoi que ce soit de faux et a à peine écrit d'exigences sans fondement. Il en paie le prix par des lacunes : les points qu'il n'a pas obtenus confirmés, il les a omis, au lieu de les marquer comme ouverts.
S'y ajoute une tension qui touche la méthode elle-même : le meilleur bras a posé le plus de questions (6,1 par dialogue). Le pilote remet ainsi en question que « poser le moins de questions possible » soit le bon objectif.
Sur l'ensemble des points et des deux experts cumulés, il manque 21 % chez B, 23 % chez Spec Kit, seulement 4 % chez le modèle sans méthode. Ce décompte regroupe tous les points et s'écarte donc légèrement des moyennes par scénario du tableau. Face à Spec Kit, B n'a donc guère moins de lacunes, mais nettement moins de fausses hypothèses. Face au modèle sans méthode, B perd surtout à cause des lacunes.
Deux autres constats plaident contre le skill dans sa forme actuelle :
- Trop de questions pour des objectifs clairs. Dans les 11 scénarios à objectif clair ou presque clair (au plus une incertitude critique ; 3 de la moitié 1, 8 de la moitié 2), B a posé en moyenne 5,0 questions, Spec Kit 3,7. Le cas de recette GE-T07 exige expressément là-dessus pas de questions superflues.
- Avance seulement sur la moitié adaptée. Sur la moitié 1, B a obtenu 88,0 % et devançait nettement Spec Kit (70,8 %). Sur la moitié 2, écrite indépendamment, B était, avec 68,6 %, derrière Spec Kit (75,2 %). L'avance sur la moitié 1 peut donc venir du fait que ses catégories correspondent au catalogue de recette de B.
Ce que nous en modifions. Le skill doit signaler les points non confirmés comme ouverts, au lieu de les supprimer. Et il doit reconnaître un objectif clair et renoncer alors aux questions. La version remaniée sera mesurée sur un nouveau corpus figé à l'avance, afin qu'elle ne soit pas taillée sur mesure pour les cas connus.
Ce que vous en retenez.
Les gestes figurent plus haut sous « Ce que vous faites dès demain ». Les chiffres qui les sous-tendent : dans le pilote, le même modèle sans modèle de méthode, avec le même budget de questions, a battu les deux méthodes. L'avantage mesuré de B se situe dans l'origine et les hypothèses : faussement supposé 0,2 % contre 4,4 % (C) et 6,8 % (A), exigences contraignantes sans fondement 2,7 contre 16,0 et 17,1 par document.
Limites de ce pilote. Six restrictions valent pour tous les chiffres ci-dessus :
- Commanditaire simulé : un modèle de langage répond avec plus de patience et de cohérence qu'un humain. Un échantillon avec de vraies personnes manque dans le pilote.
- Experts modèles : l'évaluation a été faite par deux modèles, pas par des humains. L'un provient de la même famille que les bras, ce qui peut renforcer des préférences (Panickssery et al. 2024).
- Un modèle, une exécution : tous les bras ont tourné avec un seul modèle, une fois par scénario. Le pilote ne dit rien sur d'autres modèles.
- Taille : 40 scénarios ne détectent de façon fiable que des effets moyens. Une petite avance de B sur Spec Kit n'est ainsi ni démontrée ni exclue.
- Seulement la définition de l'objectif : ce qui est mesuré, c'est la façon dont le document cerne l'intention, pas si la mise en œuvre ultérieure s'améliore.
- Écart chez Spec Kit : le bras A a cité des chemins de fichiers alors qu'il n'y avait pas de fichiers dans l'expérience. Il n'a exécuté aucune action ce faisant. Cela a été consigné, non corrigé.
Prompts, corpus, les 120 transcriptions, les évaluations et le script d'évaluation sont archivés avec des sommes de contrôle.
Niveau C : mesure d'impact au quotidien
La dernière question est la plus importante et la plus difficile : dans de vrais projets, retravaille-t-on moins de résultats parce que l'objectif avait été mal compris ? Pour cela, Provimedia relève deux grandeurs sur de vraies tâches dans Code Guardian, avant et après l'introduction du skill.
Premièrement : combien de fois une tâche annoncée comme terminée revient parce qu'elle est passée à côté de l'objectif. Deuxièmement : combien de demandes de modification de l'objectif surviennent pendant la mise en œuvre.
Cette mesure est la seule qui montre l'utilité réelle, et elle a le contrôle le plus faible, parce que les tâches ne se répètent jamais exactement. Elle complète l'étude, mais ne la remplace pas.
10. État de la recherche et mise en perspective : l'analyse des exigences orientée objectifs existe depuis plus de 30 ans
Après la mesure propre, reste la question de la place de la méthode par rapport à la recherche et aux outils existants.
L'idée de penser le logiciel à partir des objectifs humains plutôt qu'à partir des fonctions n'est pas nouvelle. Elle s'appelle Goal-Oriented Requirements Engineering (GORE). Celui qui vend l'Agentic Goal Engineering comme une invention ignore cette tradition. Celui qui la connaît peut s'appuyer dessus.
Axel van Lamsweerde définit un objectif comme un but que le système considéré doit atteindre. Les objectifs fournissent un critère précis pour savoir quand une spécification d'exigences est suffisamment complète (van Lamsweerde 2001). Les méthodes les plus connues du domaine sont :
- KAOS (Dardenne, van Lamsweerde et Fickas 1993) affine les objectifs pas à pas jusqu'aux exigences et modélise les obstacles.
- i* (Yu 1997) représente les intentions et les dépendances des parties prenantes.
- Tropos (Bresciani et al. 2004) transpose ces idées au développement logiciel orienté agents.
Une cartographie systématique de la recherche GORE existe en deux versions :
- 2019 : la cartographie de 246 travaux GORE très cités montrait un tableau décevant. Il y avait beaucoup d'idées nouvelles avec peu de citations et un petit nombre de travaux qui dominent le domaine (Horkoff et al. 2019).
- 12 octobre 2026 : la mise à jour constate que 85 pour cent des citations datent d'après 2020. Elle se consacre expressément aux défis et aux opportunités de GORE à l'ère de l'IA agentique, à savoir la surveillance, la saisie et le pilotage de systèmes agentiques (Horkoff et al. 2026).
En parallèle, la recherche sur la génération de code montre que les questions de clarification aident de façon mesurable :
- ClarifyGPT fait poser par un modèle des questions ciblées en cas d'exigences floues. Le taux de réussite (Pass@1) de GPT-4 est passé, sur le benchmark MBPP-sanitized, de 70,96 à 80,80 pour cent (Mu et al. 2023).
- HumanEvalComm modifie délibérément des descriptions de tâches par des contradictions, de l'ambiguïté et de l'incomplétude. On vérifie si les modèles posent des questions au lieu de simplement produire du code (Wu et Fard 2025).
Les deux travaux mesurent toutefois si le code est correct ensuite, et travaillent sur de petites tâches closes. Ils ne mesurent pas si les questions saisissent correctement l'objectif d'un humain.
Le troisième point de comparaison est le Spec-Driven Development. Avec Spec Kit, GitHub décrit un déroulement dans lequel l'humain décrit d'abord ce qui doit être construit et pourquoi. Ensuite naissent le plan, les tâches et la mise en œuvre. La spécification devient la source de référence de ce qui est construit (Delimarsky 2025).
Une commande ultérieure clarify recherche les passages sous-spécifiés dans la spécification et pose à ce sujet jusqu'à cinq questions ciblées (GitHub s. d.).
Spec Kit est le plus proche parent de l'approche décrite ici et une comparaison à prendre au sérieux. La différence tient à l'ordre et à l'objet. Spec Kit clarifie une spécification de fonctionnalité, donc des fonctions déjà choisies. L'Agentic Goal Engineering clarifie l'état souhaité avant que l'on sache quelle fonction doit le produire, et le conserve tout au long de la mise en œuvre comme étalon de vérification.
| Approche | Ce qu'elle accomplit déjà | Ce que l'Agentic Goal Engineering ajoute |
|---|---|---|
| GORE (KAOS, i*, Tropos) | Modèles d'objectifs, affinement, conflits, obstacles | Recueil dialogué par un LLM, raccordement à des agents exécutants |
| Spec Kit | Spécification, questions de clarification, plan, tâches | Détermination de l'objectif avant la spécification de fonctionnalité, étalon figé |
| Loop Engineering | Itération avec condition d'arrêt | Une condition d'arrêt vérifiée et validée par l'humain |
| Graph Engineering | Dépendances, transmissions, pilotage | Lien immuable de chaque nœud avec l'intention d'origine |
Commandes /goal | Continuer à travailler jusqu'à ce qu'une condition soit remplie | La condition elle-même, avec origine et protocole de vérification |
La mise en perspective est donc sobre : l'Agentic Goal Engineering n'invente pas l'analyse des exigences orientée objectifs. Nouvelle est sa mise en œuvre comme processus de pilotage assisté par IA, dialogué et durablement vérifiable pour des agents de programmation autonomes.
Pour vous, cela signifie : si vous utilisez Spec Kit, placez la clarification de l'objectif en amont et ne démarrez la spécification qu'avec un Goal Contract validé.
11. Limites de la méthodologie
Pour finir, la question de savoir où la méthode elle-même rencontre ses limites. L'Agentic Goal Engineering ne résout pas tous les problèmes, et il crée ses propres risques. Cinq limites relèvent d'une présentation honnête.
- La première comparaison ne plaide pas en faveur de la méthodologie. Dans le pilote de 120 dialogues, aucune avance sur Spec Kit n'est démontrée, et un modèle sans méthode a mieux cerné l'intention. La méthodologie est fondée en raison, son utilité ne l'est pas.
- Un entretien coûte du temps. Pour de petites tâches univoques, il est superflu. La méthodologie doit reconnaître quand elle n'est pas nécessaire, sinon elle devient une cérémonie.
- Les règles de prompt ne sont pas une limite dure. Que le skill ne programme pas, c'est écrit dans ses instructions. Un verrou de lecture imposé techniquement sur le code de production exige en plus des autorisations, des hooks ou un sandbox dans Claude Code.
- L'humain reste la source. Si le commanditaire ne sait lui-même pas ce qu'il veut, aucune méthodologie ne peut le faire surgir par des questions. Elle peut en revanche rendre visible qu'il en est ainsi et proposer un objectif exploratoire.
- Les termes sont récents. Loop et Graph Engineering ne sont pas normalisés, et « Goal Engineering » est déjà employé dans un autre sens. La délimitation de cet article est une proposition, pas un standard.
12. Conclusion : construire d'abord l'objectif, puis la solution
Que reste-t-il après la méthode, l'exemple et la mesure ? Les agents sont devenus bons pour remplir des conditions. Le Loop Engineering les fait itérer jusqu'à ce qu'une condition soit remplie. Le Graph Engineering répartit le travail entre de nombreux agents. Les commandes /goal les maintiennent en marche jusqu'à ce qu'un vérificateur approuve. Tout cela est d'autant plus efficace que la condition est précise, et d'autant plus dangereux qu'elle l'est moins.
L'Agentic Goal Engineering fait de la condition son propre objet de travail. Trois principes le résument :
- Ce n'est pas une méthode de planification. Il fixe l'état qui doit être atteint. La recherche de solutions et la planification commencent après.
- Ce n'est pas un questionnaire. L'IA doit comprendre l'intention, reconnaître les lacunes décisives et les combler avec aussi peu de questions bien choisies que possible ; dans le pilote, ce n'est pas encore tenu, et le meilleur bras a même posé le plus de questions.
- Ce n'est pas une optimisation de prompt ponctuelle. Le contrat validé reste l'étalon pendant tout le développement. Les agents peuvent changer de chemin, mais pas décider de leur propre chef qu'un autre résultat compte comme un succès.
La maxime est : First engineer the goal. Then engineer the solution. Construire d'abord l'objectif, puis la solution.
La première comparaison que nous avons menée invite à la modestie. Une méthode qui évite les fausses hypothèses, mais laisse des lacunes, n'est pas encore une meilleure méthode. Nous tenons les principes pour justes ; que le skill les applique mieux qu'un modèle sans méthode, il lui reste à le démontrer.
Provimedia développe actuellement le skill /goalengine comme premier composant pour Code Guardian, d'abord comme pure définition d'objectif sans exécution. Si vous employez des agents dans vos propres projets et avez besoin d'accompagnement, vous trouverez notre offre sous Développement d'IA et agents.
Questions fréquentes
Pour référence, les questions que les lecteurs posent le plus souvent.
Qu'est-ce que l'Agentic Goal Engineering ?
L'Agentic Goal Engineering est une étape préparatoire pour les agents de programmation : une IA interroge le commanditaire jusqu'à ce qu'on sache à quoi reconnaître le succès. Il en résulte un contrat écrit et validé, avec des critères vérifiables et sans imposition technique. Il doit empêcher que des agents optimisent un objectif formulé de façon imprécise, et sert plus tard d'étalon pour la vérification.
En quoi le Goal Engineering se distingue-t-il du Loop Engineering ?
Une boucle ne vérifie que la condition qu'elle reçoit. Un agent rend un tableau de bord rapide grâce à un cache, Lighthouse affiche 100 points, tous les tests sont au vert, et les chiffres ont pourtant une heure. La boucle a tourné sans défaut, l'objectif était autre. Le Goal Engineering vérifie au préalable si la condition correspond à l'intention de l'humain.
En quoi le Goal Engineering se distingue-t-il du Graph Engineering ?
Le Graph Engineering organise quel agent accomplit quel travail dans quel ordre et comment les résultats sont transmis. Le Goal Engineering ne décide ni des agents, ni des ordres, ni des copies de travail. Il fournit au graphe l'étalon auquel chaque tâche se réfère par son AC-ID.
La commande /goal de Claude Code ne suffit-elle pas ?
La commande /goal fait continuer Claude jusqu'à ce qu'un modèle de vérification juge la condition fixée remplie. Elle vérifie si la condition est valide, pas si elle est juste. Selon la documentation, le vérificateur n'exécute en outre aucune commande et ne lit aucun fichier. Le Goal Engineering fournit la condition vérifiée et l'étalon d'une vérification indépendante des preuves.
N'est-ce pas la même chose que le Spec-Driven Development ?
Non. Le Goal Engineering est l'étape qui précède, et les deux peuvent se combiner : clarifier d'abord l'objectif, puis écrire la spécification. La spécification décrit des fonctions, le Goal Contract l'état que ces fonctions doivent produire. Le Goal Engineering fournit en amont l'état cible validé avec ses critères d'acceptation et donne à la spécification, au plan et aux tâches un étalon vérifiable.
Combien de questions l'IA pose-t-elle ?
Une à trois au plus par tour, et seulement jusqu'à ce que toutes les incertitudes décisives soient levées. Si l'objectif est clair dès le départ, les questions disparaissent entièrement. C'est ainsi que c'est prévu ; dans le pilote, le skill a toutefois encore posé en moyenne 5,0 questions pour des objectifs clairs (section 9), et le modèle sans méthode a posé en moyenne 6,1 questions et cerné le mieux. Chaque question possible est évaluée au préalable selon l'ampleur dont sa réponse modifie l'objectif et le coût d'une fausse hypothèse.
Qui valide le Goal Contract, et que signifie la validation ?
Seul l'humain habilité peut valider, et ce une version précise qui lui a été affichée. Un simple « ça va » avant l'affichage du contrat ne compte pas. La validation autorise la définition de l'objectif, pas la mise en œuvre, ni des dépenses, ni un déploiement. Des modifications ultérieures créent une nouvelle version, qui doit être de nouveau validée.
Est-il prouvé que la méthodologie donne de meilleurs résultats ?
Non. Dans la première comparaison du 28 octobre 2026, avec 40 scénarios, 120 dialogues, un commanditaire simulé et deux modèles experts, la Goal Engine a cerné 78 % des points décisifs, Spec Kit 73 % et le même modèle sans méthode 89 %. L'avance sur Spec Kit n'est pas démontrée statistiquement. La Goal Engine n'a presque jamais supposé quoi que ce soit de faux, mais a omis davantage de points.
Sources
- Anthropic (2025) : Claude 3.7 Sonnet System Card, section 6 « Excessive Focus on Passing Tests ».
- Anthropic (s. d.) : Documentation de Claude Code : /goal. Consulté le 28.10.2026.
- Arike, R. ; Donoway, E. ; Bartsch, H. ; Hobbhahn, M. (2025) : Technical Report: Evaluating Goal Drift in Language Model Agents. arXiv:2505.02709.
- Belcic, I. ; Stryker, C. (2026) : What is loop engineering? IBM Think, 17.07.2026.
- Bouchard, L.-F. (2026) : Graph Engineering vs Loop Engineering: What Actually Changed, 22.07.2026.
- Bresciani, P. ; Perini, A. ; Giorgini, P. ; Giunchiglia, F. ; Mylopoulos, J. (2004) : Tropos: An Agent-Oriented Software Development Methodology. Autonomous Agents and Multi-Agent Systems 8, p. 203–236. doi:10.1023/B:AGNT.0000018806.20944.ef
- Claburn, T. (2026) : Article sur le Loop Engineering. The Register, 24.06.2026.
- Dardenne, A. ; van Lamsweerde, A. ; Fickas, S. (1993) : Goal-directed requirements acquisition. Science of Computer Programming 20(1–2), p. 3–50. doi:10.1016/0167-6423(93)90021-G
- Delimarsky, D. (2025) : Spec-driven development with AI: Get started with a new open source toolkit. GitHub Blog, 02.09.2025.
- Feng et al. (2026) : Graph Engineering in the Era of LLM Agents: From Individual Intelligence to System Intelligence. arXiv:2608.21156.
- GitHub (s. d.) : Spec Kit, modèle de commande
clarify. Consulté le 28.10.2026. - Goodhart, C. A. E. (1975) : Problems of Monetary Management: The U.K. Experience. Papers in Monetary Economics, Vol. I, Reserve Bank of Australia.
- Greyling, C. (s. d.) : goal-engineering. Dépôt GitHub. Consulté le 28.10.2026.
- Horkoff, J. et al. (2019) : Goal-oriented requirements engineering: an extended systematic mapping study. Requirements Engineering 24(2), p. 133–160. doi:10.1007/s00766-017-0280-z
- Horkoff, J. et al. (2026) : A systematic mapping of goal-oriented requirements engineering: reflections, impact, and the way forward. Requirements Engineering 31, Art. 20. doi:10.1007/s00766-026-00476-7
- ISO/IEC/IEEE 29148:2018 : Systems and software engineering – Life cycle processes – Requirements engineering, section 5.2.5.
- Krakovna, V. et al. (2020) : Specification gaming: the flip side of AI ingenuity. Google DeepMind, 21.04.2020.
- Lulla, Nersesyan, Mohsenimofidi, Treude, Baltes (2026) : Loop Engineering: Building Blocks, Adoption, and Impact. arXiv:2608.21884.
- Mu, F. et al. (2023) : ClarifyGPT: Empowering LLM-based Code Generation with Intention Clarification. arXiv:2310.10996.
- NASA (s. d.) : Independent Verification and Validation: Overview. Consulté le 28.10.2026.
- North, D. (2006) : Introducing BDD. Better Software, mars 2006.
- OpenAI (s. d.) : Using goals in Codex. OpenAI Cookbook. Consulté le 28.10.2026.
- Panickssery, A. ; Bowman, S. R. ; Feng, S. (2024) : LLM Evaluators Recognize and Favor Their Own Generations. arXiv:2404.13076.
- Shen, L. et al. (2026) : Learning to Steer LLM Agents and Multi-Agent Systems. arXiv:2610.22316.
- Strathern, M. (1997) : « Improving ratings » : audit in the British University system. European Review 5(3), p. 305–321.
- van Lamsweerde, A. (2001) : Goal-Oriented Requirements Engineering: A Guided Tour. Proceedings RE'01, p. 249–262. doi:10.1109/ISRE.2001.948567
- von Arx, S. ; Chan, L. ; Barnes, B. (2025) : Recent Frontier Models Are Reward Hacking. METR, 05.06.2025.
- Wang, J. ; Qian, H. ; Hu, Y. ; Zhang, J. ; Liu, Z. (2026) : AgentSWE: Can Coding Agents Build the Agent You Actually Want? arXiv:2610.13361.
- Willison, S. (2026) : Agentic Engineering Patterns, 23.02.2026.
- Wu, J. J. ; Fard, F. H. (2025) : HumanEvalComm: Benchmarking the Communication Competence of Code Generation for LLMs and LLM Agent. ACM TOSEM. doi:10.1145/3715109
- xAI (s. d.) : Grok Build: Modes and Commands. Consulté le 28.10.2026.
- Yu, E. S. K. (1997) : Towards modelling and reasoning support for early-phase requirements engineering. Proceedings ISRE '97, p. 226–235. doi:10.1109/ISRE.1997.566873
- Zheng, L. et al. (2023) : Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena. NeurIPS 2023 Datasets and Benchmarks. arXiv:2306.05685.
Remarque : cet article décrit une méthodologie en cours de développement, son plan de vérification et les résultats d'un premier pilote avec commanditaire simulé. Il ne contient aucune promesse de performance pour des outils particuliers. Toutes les indications sur des produits de tiers reproduisent leur documentation publique à la date du 28.10.2026.
Partager l’article
Restez informé
Recevez les derniers articles, analyses et actualités du secteur directement dans votre boîte mail.
Décidez vous-même ce que Google vous montre
Google vous laisse choisir quelles sources apparaissent en priorité dans vos résultats de recherche : dans les actualités et dans les réponses IA. Deux clics, et vous voyez les sites auxquels vous faites confiance.
Ajouter provimedia.de à mes sources préféréesArticles similaires
D’autres articles susceptibles de vous intéresser.
Invité du podcast Chefgeflüster : combien d'IA nous fait du bien ?
J'ai été invité par Lars et Silvio dans le podcast Chefgeflüster. L'épisode #42 pose la question de savoir combien d'IA est bénéfique pour une entreprise et où l'humain doit rester.
L'IA en entreprise : 7 règles pour que le dirigeant garde la main (à propos de Chefgeflüster #42)
Un collaborateur copie une offre dans la version gratuite de ChatGPT : sept règles aux gestes concrets montrent aux dirigeants de petites entreprises comment utiliser l'IA tout en gardant le contrôle. Occasion : Chefgeflüster #42.
Apprendre le prompt engineering : définition, composantes et exemples pratiques
Le prompt engineering sonne comme une formule magique, mais c'est un savoir-faire qui s'apprend. Ce guide présente les six composantes d'un bon prompt, avec de vrais exemples avant-après tirés du quotidien professionnel.
Votre équipe utilise ces modèles ?
Développez la compétence IA de votre équipe et documentez-la avec une attestation de participation — dans le cadre de l'article 4 de l'AI Act européen.