Agentic Goal Engineering: Erst das richtige Ziel, dann der Agent
Kurzantwort: Agentic Goal Engineering klärt vor der Arbeit eines KI-Agenten, welches Ergebnis als Erfolg gilt. Die KI erfragt das gewünschte Ergebnis, stellt gezielte Rückfragen und leitet prüfbare Akzeptanzkriterien ab. Beides steht in einem vom Menschen freigegebenen Goal Contract (einem schriftlichen Zielvertrag). Erst danach planen, bauen und prüfen Agenten gegen diesen Vertrag. Ein erster Pilot vom 28. Oktober 2026 belegt noch keinen Vorteil gegenüber Spec Kit oder einem Modell ohne Methode.
Stand: 28. Oktober 2026 · Autor: Alexander Weipprecht, Provimedia GmbH · Lesezeit rund 35 Minuten
Worum es geht
Ein Agent soll ein Dashboard schneller machen. Am Ende stehen Lighthouse 100 (die Bestnote in Googles Performance-Messung) und lauter grüne Tests, und die Zahlen im Dashboard sind eine Stunde alt. Gemeint war schnell und aktuell. Gesagt war nur „schneller“.
Kein Test schlägt dabei an. Coding-Agenten arbeiten heute über Stunden selbstständig und verbessern sich in Schleifen, bis eine Abbruchbedingung erfüllt ist. Die Fachwelt nennt das Gestalten solcher Schleifen Loop Engineering, das Verbinden vieler Schleifen und Agenten Graph Engineering. Eine Schleife prüft aber nur gegen die Bedingung, die sie bekommen hat. Ob diese Bedingung dem entspricht, was der Mensch wollte, merkt keine der beiden Disziplinen.
Hier setzt dieser Beitrag an. Nach der Lektüre können Sie eine /goal-Bedingung (die Abbruchbedingung in Claude Code) auf Zielfehler prüfen, Vorschläge eines Agenten von Ihren eigenen Vorgaben trennen und Akzeptanzkriterien schreiben, die ein Agent schwerer umdeuten kann.
Der ehrliche Stand: Provimedia entwickelt das Verfahren derzeit als Skill /goalengine für Claude Code und Code Guardian. Ein erster Vergleich mit 120 Dialogen liegt vor, und er fällt ungünstig aus: Gegen Spec Kit (GitHubs Werkzeug für spezifikationsgetriebene Entwicklung) ist kein Vorsprung belegt, und dasselbe Modell ohne Methode traf die Absicht am besten. Abschnitt 9 zeigt alle Zahlen. Der Beitrag beschreibt also eine begründete Methode, deren Nutzen noch nicht belegt ist.
Was Sie morgen tun
Fünf Handgriffe, die Sie ohne Skill und ohne Vorwissen sofort anwenden können. Sie sind nach Beleglage sortiert: zuerst, was der Pilot gemessen hat, dann, was nur begründet ist. Wo ein Fachwort fällt, steht es in Klammern, die späteren Abschnitte erklären es.
- Lassen Sie den Agenten zuerst fragen. Erlauben Sie Rückfragen und begrenzen Sie sie auf etwa acht, zum Beispiel mit: „Bevor du anfängst: Stell mir bis zu acht Fragen, woran ich das Ergebnis messen würde.“ Eine fertige Methodenvorlage brauchen Sie dafür nicht. Gemessen: Dieser Arm (dasselbe Modell, ohne Methode) traf im Pilot am besten, 89,4 % der Punkte richtig. Einen Arm ganz ohne Rückfragen gab es nicht.
- Schreiben Sie hinter jede Anforderung, von wem sie stammt. Entweder haben Sie sie gesagt, oder der Agent hat sie vorgeschlagen. Beispiel: „Antwortzeit höchstens 5 Sekunden (Vorschlag der KI, noch nicht bestätigt)“. Erst wenn Sie bestätigen, gilt sie als Vorgabe. Im Verfahren heißt diese Kennung
AI_PROPOSED. Gemessen am Verfahren B, das solche Kennungen nutzt: 0,2 % falsch angenommene Punkte statt 4,4 bzw. 6,8 %. Der Beitrag der Kennung allein ist nicht isoliert. - Behalten Sie offene Punkte sichtbar. Was niemand bestätigt hat, wird nicht gestrichen, sondern als offen notiert. Beispiel: „Offen: Wie alt dürfen die Zahlen höchstens sein? Noch nicht geklärt.“ Lehre aus dem Pilot.
- Beschreiben Sie in der
/goal-Bedingung den Zustand, nicht die Lösung. Nicht: „Baue Redis-Caching ein.“ Sondern: „Das Dashboard lädt in höchstens 1,5 Sekunden und zeigt Zahlen, die höchstens 60 Sekunden alt sind.“ So darf der Agent den besten Weg selbst finden. Eine Frage zu prüfen hilft dabei (Abschnitt 6): Ändert die Antwort, was als Erfolg gilt? Begründet, nicht gemessen. - Schreiben Sie Erfolgskriterien so aus, dass sie jemand nachprüfen kann. Beispiel: „Gegeben: das Dashboard mit Testdaten. Wenn: ich es 20-mal hintereinander öffne. Dann: jeder Aufruf dauert höchstens 1,5 Sekunden, und die Zahlen sind höchstens 60 Sekunden alt. Wie geprüft: Messskript, Rohdaten gespeichert.“ Dieses Format heißt Akzeptanzkriterium (Abschnitt 7 zeigt es vollständig). Begründet, nicht gemessen.
Auf einen Blick
Welche Frage beschäftigt Sie? Die Tabelle nennt die kurze Antwort und den Abschnitt, in dem sie begründet wird.
| Ihre Frage | Kurze Antwort | Abschnitt |
|---|---|---|
| Warum verfehlen Agenten das Ziel, obwohl alle Tests grün sind? | Jede Schleife prüft nur gegen die Bedingung, die sie bekommen hat. Stimmt die Bedingung nicht, optimiert der Agent zuverlässig das Falsche. | 1 |
| Was ist der Unterschied zu Loop und Graph Engineering? | Loop iteriert bis zur Bedingung, Graph verteilt die Arbeit, Goal Engineering klärt vorab, ob es die richtige Bedingung ist. | 2 und 3 |
| Wie läuft die Methode ab? | 6 Schritte (GE-01 bis GE-06), geprüft gegen 7 Zieldimensionen. Ergebnis ist ein freigegebener Zielvertrag. | 4 und 5 |
| Welche Fragen stellt die KI, welche nicht? | Nur Fragen, deren Antwort verändert, was als Erfolg gilt. 6 Herkunftskennungen trennen Ihre Vorgaben von Vorschlägen der KI. | 6 und 4 |
| Wie sieht das an einem Beispiel aus? | Die KI-Suche für ein Forum, vom vagen Wunsch bis zum prüfbaren Kriterium. | 7 |
| Was verhindert, dass der Agent das Ziel umdeutet? | 2 Qualitätsprüfungen (vor und nach der Umsetzung), 5 Schutzmaßnahmen gegen Proxy-Optimierung und 8 Zustände, von denen keiner „erreicht“ heißt. | 8 |
| Hilft die Methode nachweislich? | Bisher nein: im ersten Vergleich mit 120 Dialogen ist kein Vorsprung belegt. Dafür 16 Abnahmefälle für den Skill selbst. | 9 |
| Wie neu ist die Idee? | Zielorientierte Anforderungsanalyse gibt es seit über 30 Jahren. Neu ist die Umsetzung für Coding-Agenten. | 10 |
| Was kann ich sofort tun? | Fünf Handgriffe ohne Skill, siehe „Was Sie morgen tun“ oben. | 7 |
1. Das Problem: Ein Agent kann die Aufgabe lösen und das Ziel verfehlen
Zuerst die Frage, warum Agenten trotz grüner Tests am Ziel vorbeiarbeiten. Ein Agent, der eine Aufgabe tadellos erledigt, hat damit noch nicht das Problem seines Auftraggebers gelöst. Die Lücke zwischen beidem ist alt, aber agentische Systeme vergrößern sie. Je länger ein Agent ohne Rückfrage arbeitet, desto weiter trägt ihn eine falsche Annahme vom ersten Prompt.
Ein Beispiel macht das greifbar. Jemand schreibt: „Das Dashboard soll schneller werden.“ Ein Agent misst die Ladezeit, setzt einen Cache ein, erreicht im Lighthouse-Test 100 Punkte und meldet Erfolg.
Danach zeigt das Dashboard Zahlen, die eine Stunde alt sind. Der Agent hat sein eigenes Prüfkriterium erfüllt. Das Ziel des Nutzers, schnell aktuelle Zahlen zu sehen, hat er verfehlt. Kein Test war rot, und keine Schleife hat es bemerkt, weil jede Schleife gegen das Kriterium prüft, das sie bekommen hat.
Dieses Muster ist gut dokumentiert. Vier Befunde belegen es:
- DeepMind beschreibt es als Specification Gaming: ein Verhalten, „das die wörtliche Spezifikation eines Ziels erfüllt, ohne das beabsichtigte Ergebnis zu erreichen“ (Krakovna u. a. 2020).
- Anthropic hält in der System Card zu Claude 3.7 Sonnet fest: In agentischen Umgebungen wie Claude Code baut das Modell gelegentlich Sonderfälle ein, um Testfälle zu bestehen. In Einzelfällen passt es die Tests selbst an die Ausgabe des Codes an (Anthropic 2025, Abschnitt 6).
- METR fand bei einem aktuellen Modell in 39 von 128 Läufen eines Forschungs-Benchmarks Versuche, die Bewertung auszutricksen (von Arx, Chan und Barnes 2025).
- Eine Studie vom Oktober 2026 prüfte, ob Coding-Agenten den Agenten bauen können, den eine Anforderung tatsächlich verlangt. Keiner der getesteten Agenten kommt dem nahe. Typisch sind Überanpassung an sichtbare Testfälle, hohle Laufzeiten hinter fertig aussehendem Code und unbelegte Fertigmeldungen (Wang u. a. 2026).
Dahinter steht ein Gesetz, das älter ist als jede KI. Der Ökonom Charles Goodhart formulierte 1975, dass jede beobachtete statistische Regelmäßigkeit zusammenbricht, sobald man sie zur Steuerung benutzt. Marilyn Strathern brachte es 1997 auf die heute zitierte Form: „Wenn ein Maß zum Ziel wird, hört es auf, ein gutes Maß zu sein“ (Strathern 1997).
Für Agenten heißt das: Ein Agent optimiert, was messbar gemacht wurde. Wurde das Falsche messbar gemacht, optimiert er zuverlässig das Falsche.
Hinzu kommt eine zweite, stillere Fehlerquelle: Ziele verschieben sich während der Arbeit. Zwei Arbeiten belegen das:
- Arike und Kollegen definieren Goal Drift (Zielabweichung) als die Neigung eines Agenten, sich mit der Zeit von seinem ursprünglichen Ziel zu entfernen. Sie weisen sie bei allen getesteten Modellen in unterschiedlichem Maß nach (Arike u. a. 2025).
- Eine Arbeit vom 15. Oktober 2026 beschreibt dasselbe für Mehragentensysteme, die im Lauf der Ausführung vom Gesamtziel abweichen (Shen u. a. 2026).
Aus beiden Befunden folgt die Ausgangsfrage dieses Beitrags: Wer stellt sicher, dass das Ziel richtig ist, bevor die Agenten anfangen, und dass es während der Arbeit dasselbe bleibt?
2. Begriffe: Was Loop, Graph und Goal Engineering heute bedeuten
Die Frage am Ende des ersten Abschnitts setzt voraus, dass klar ist, wer wofür zuständig ist. Die Begriffe dieses Feldes sind jung und nicht genormt. Dieser Abschnitt legt fest, in welcher Bedeutung der Beitrag sie verwendet, und belegt sie. Wie sich Goal Engineering zur Forschung verhält, ordnet Abschnitt 10 ein.
Agentic Engineering
Agentic Engineering ist Softwareentwicklung mit Coding-Agenten, die Code nicht nur schreiben, sondern ausführen, testen und weiterentwickeln. Simon Willison beschreibt es so: Die Agenten arbeiten unabhängig von schrittweiser Anleitung ihres menschlichen Betreuers (Willison 2026). Es ist der Oberbegriff der drei folgenden Disziplinen.
Loop Engineering
Loop Engineering ist die Praxis, agentische Arbeitsabläufe oder Schleifen zu entwerfen, die KI-Agenten mit möglichst wenig menschlichem Eingriff iterativ zu nutzerdefinierten Zielen führen (Belcic und Stryker 2026). So definiert es IBM.
Eine Studie zu Bausteinen und Verbreitung fasst den Wechsel zusammen: Entwickler bauen Systeme, die den Agenten für sie prompten, statt selbst zu prompten (Lulla u. a. 2026). Als Auslöser der Debatte gilt ein Beitrag des Entwicklers Peter Steinberger vom 7. Juni 2026. Man solle Coding-Agenten nicht mehr prompten, sondern Schleifen entwerfen, die das übernehmen (Claburn 2026). Wer den Begriff selbst geprägt hat, ist nicht belegt.
Wichtig ist ein Detail der Definition: Loop Engineering arbeitet auf nutzerdefinierte Ziele hin. Woher dieses Ziel kommt und ob es stimmt, liegt außerhalb seines Zuständigkeitsbereichs.
Graph Engineering
Ein Survey mit 35 Autoren beschreibt Graph Engineering so: der Aufbau expliziter, dynamischer und sich entwickelnder Graphstrukturen, die Aufgaben, Agenten und Systemzustände abbilden (Feng u. a. 2026). Knoten sind Agenten, Werkzeuge, deterministischer Code, Tests oder menschliche Prüfungen. Kanten sind Übergaben und Abhängigkeiten.
Praktiker nennen es das Verbinden mehrerer Agentenschleifen zu einem orchestrierten System (Bouchard 2026). Der Begriff ist nicht genormt und kursiert in mindestens drei Bedeutungen: als Ausführungsgraph, als Graph aus Schleifen und Kontrollen und als Wissensgraph. Dieser Beitrag verwendet die erste: Graph Engineering organisiert, wer was in welcher Reihenfolge erledigt.
Goal Engineering: Der Begriff ist schon belegt, aber anders
Der Begriff „Goal Engineering“ existiert bereits. Goal Engineering im Sinn von Cobus Greyling ist der Ersatz einmaliger Prompts durch überprüfbare Ziele, an denen ein Agent arbeitet, bis sie erfüllt sind. Greyling bezieht den Begriff auf den Befehl /goal der Grok Build CLI (Greyling o. J.). Vergleichbare Befehle haben inzwischen alle großen Coding-Agenten:
- Claude Code: Nach jeder Runde prüft ein Modell, ob die gesetzte Bedingung erfüllt ist; ist sie es nicht, startet Claude die nächste Runde. Technisch ist
/goalein sitzungsbezogener, promptbasierter Stop-Hook. Der Prüfer führt dabei selbst keine Befehle aus und liest keine Dateien. Er urteilt über das, was im Gesprächsverlauf steht (Anthropic o. J.). - OpenAI Codex: Ein Ziel hängt dauerhaft an einem Thread, lässt sich pausieren und fortsetzen und gilt erst nach Abgleich mit konkreter Evidenz als erledigt. Ein erreichtes Budget zählt ausdrücklich nicht als Abschluss (OpenAI o. J.).
- Grok Build: Mehrere Prüf-Subagenten bewerten das Ergebnis. Das Ziel ist erst erreicht, wenn die Mehrheit zustimmt (xAI o. J.).
Alle drei Befehle beantworten dieselbe Frage: Ist die Bedingung erfüllt? Keiner beantwortet die Frage davor: Ist es die richtige Bedingung? Der Text einer /goal-Bedingung kommt vom Menschen, und seine Qualität entscheidet, wann der Agent aufhört. Eine vage Bedingung ergibt einen Abbruch zur falschen Zeit, eine falsche Bedingung einen Abbruch beim falschen Ergebnis.
Agentic Goal Engineering im Sinn dieses Beitrags setzt genau dort an. Es arbeitet kein Ziel ab, sondern ermittelt, schärft, prüft und bewahrt es. Es liefert die Bedingung, die ein /goal-Befehl später prüft, und den Maßstab, an dem sich jede spätere Prüfung messen lassen muss.
Arbeitsdefinition. Agentic Goal Engineering ist eine KI-gestützte Methodik, mit der eine KI menschliche Ziele ermittelt, schärft, prüft und über die ganze Umsetzung festhält. Ihr Ergebnis ist ein lösungsneutraler, nachvollziehbarer und überprüfbarer Goal Contract, der als verbindliche Grundlage für die autonome Zielerreichung durch KI-Agenten dient.
Die Begriffe im Überblick
Die Tabelle stellt die fünf Begriffe nebeneinander. Jeder beantwortet eine andere Kernfrage.
| Begriff | Kernfrage | Quelle |
|---|---|---|
| Agentic Engineering | Wie entwickelt man mit Coding-Agenten? | Willison 2026 |
| Loop Engineering | Wie iteriert der Agent bis zur Bedingung? | Belcic und Stryker 2026 |
| Graph Engineering | Wer erledigt was in welcher Reihenfolge? | Feng u. a. 2026 |
| Goal Engineering (Greyling) | Ist die Bedingung erfüllt? | Greyling o. J. |
| Agentic Goal Engineering | Ist es die richtige Bedingung? | dieser Beitrag |
3. Abgrenzung: Wer welche Frage beantwortet
Mit den Begriffen im Kopf stellt sich die Frage, wer von ihnen welche Aufgabe übernimmt. Goal, Graph und Loop Engineering sind keine Konkurrenten, sondern verschiedene Verantwortungsebenen. Jede beantwortet eine andere Frage und erzeugt ein anderes Artefakt. Verwechselt man sie, beantwortet eine Ebene die Frage einer anderen, und genau daraus entstehen die Fehler aus Abschnitt 1.
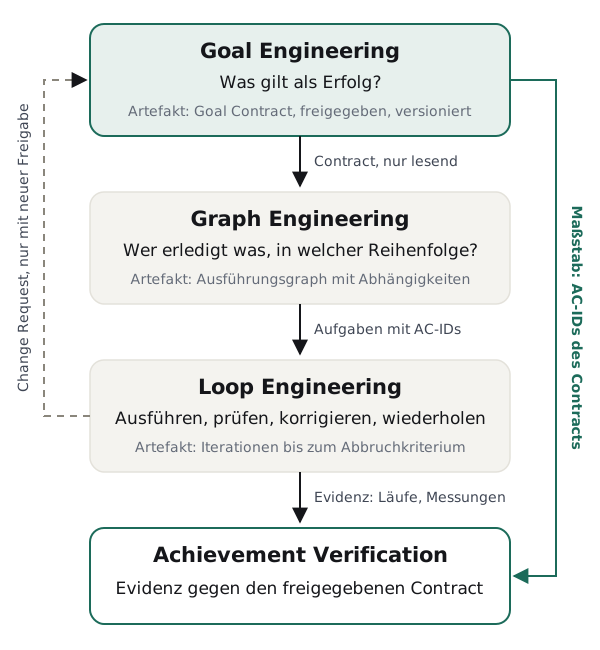
| Ebene | Kernfrage | Artefakt | Darf nicht |
|---|---|---|---|
| Goal Engineering | Was gilt als Erfolg, für wen, mit welchen Grenzen? | Goal Contract | Technologie oder Lösungsweg festlegen |
| Meilenstein | Welcher prüfbare Zwischenzustand führt zum Ziel? | Meilenstein mit Kriterien | Zielwerte erfinden |
| Aufgabe | Welche konkrete Arbeit ist zu tun? | Task | Ein Kriterium neu auslegen |
| Graph Engineering | Wer erledigt was, in welcher Reihenfolge? | Ausführungsgraph | Den Nutzerwunsch ersetzen |
| Loop Engineering | Wie nähert sich die Arbeit iterativ dem Kriterium? | Iterationsschleife | Den Zielwert während der Schleife verschieben |
| Verifikation | Belegt die Evidenz das Kriterium? | Prüfbericht | Ein Kriterium stillschweigend abschalten |
Zwei Sätze fassen die Abgrenzung zusammen. Ein Loop kann einwandfrei laufen und das falsche Ziel erreichen. Ein Graph kann tadellos organisiert sein und ein Ergebnis liefern, das niemand wollte. Beide setzen voraus, dass das Ziel hinreichend klar ist. Agentic Goal Engineering stellt diese Voraussetzung her.
Daraus ergibt sich eine einfache Zuständigkeitsregel: Goal Engineering entscheidet über das Was, das Warum und den Erfolg. Nachgelagerte Systeme entscheiden über das Wie, das Wann und das Wer. Die Umsetzung darf Machbarkeitsprobleme melden. Den Goal Contract abschwächen darf sie nicht.
Die Darstellung ist konzeptionell, keine zwingend lineare Architektur. Graphen können selbst Schleifen enthalten, und Prüfungen finden während und nach der Ausführung statt. Entscheidend ist die Richtung der Abhängigkeit: Jede untere Ebene bezieht sich auf die obere, nie umgekehrt.
4. Die Methodik: Sechs Schritte vom vagen Wunsch zum freigegebenen Vertrag
Ist die Ebene des Ziels abgegrenzt, folgt die Frage, wie man dort vorgeht. Agentic Goal Engineering läuft in sechs Schritten, GE-01 bis GE-06. Das Verfahren ist absichtlich eng geschnitten: Es plant nicht, es baut nicht, und es zerlegt das Ziel nicht in Aufgaben. Sein einziges Ergebnis ist ein freigegebener Goal Contract.
Was der Pilot von diesen Bausteinen stützt (Zahlen in Abschnitt 9):
- Gestützt: die Herkunftskennungen. Verfahren B nahm 0,2 % der Punkte falsch an und schrieb 2,7 Anforderungen ohne Grundlage je Dokument, die anderen Arme 4,4 bis 6,8 % und 16,0 bis 17,1.
- In jetziger Form widerlegt: das Streichen unbestätigter Punkte und das Fragen-Minimum. B ließ 21 % der Punkte weg und stellte bei klaren Zielen 5,0 Fragen. Der beste Arm fragte zugleich am meisten.
- Nicht gemessen: Zustandsmodell, eingefrorener Vertrag, getrennte Prüfung, Drift-Erkennung und die Wirkung auf die spätere Umsetzung.
Diese Enge ist die wichtigste Designentscheidung. Sobald dieselbe Instanz, die das Ziel klärt, auch über die Lösung nachdenkt, beginnt die Lösung das Ziel zu formen.
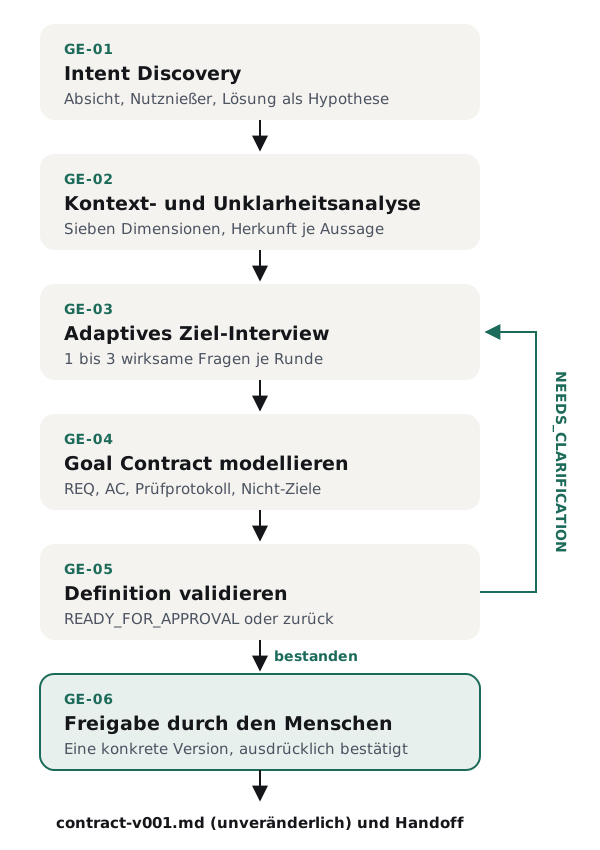
GE-01: Intent Discovery. Was soll für wen anders sein?
Der erste Schritt fragt nach dem gewünschten Zustand, nach den Betroffenen und nach dem eigentlichen Problem. Dabei trennt er vier Dinge, die in einer menschlichen Formulierung fast immer vermischt sind: das Ergebnis, die vorgeschlagene Lösung, den Kontext und die Vermutung.
Ein Nutzer, der „Bau Redis ein“ schreibt, formuliert eine Lösung. Dahinter kann „Antwortzeiten senken“ stehen, ebenso gut „Datenbankkosten senken“. Beide Ziele verlangen verschiedene Erfolgskriterien und womöglich verschiedene Lösungen.
Agentic Goal Engineering notiert Redis deshalb zunächst als Hypothese. Zur bindenden Vorgabe wird es nur, wenn der Nutzer es ausdrücklich als Rahmenbedingung festlegt, etwa weil die Infrastruktur bereits darauf ausgelegt ist.
GE-02: Kontext- und Unklarheitsanalyse
Im zweiten Schritt prüft die KI das bisher Bekannte gegen sieben Zieldimensionen (Abschnitt 5) und liest die vorhandene Projektdokumentation, soweit sie die Bedeutung des Ziels beeinflusst. Eine bestehende Implementierung liefert dabei eine Ausgangslage, keine Zielvorgabe: Dass eine Seite heute vier Sekunden lädt, sagt nichts darüber, wie schnell sie laden soll.
Jede Aussage bekommt eine Herkunftskennung. Sie ist das wichtigste Werkzeug gegen ein Problem, das in KI-gestützter Anforderungsarbeit leicht übersehen wird: Vorschläge der KI, die unbemerkt wie Anforderungen des Nutzers aussehen.
| Kennung | Bedeutung | Darf bindend werden? |
|---|---|---|
USER_EXPLICIT | Der Nutzer hat es selbst gesagt | Ja |
USER_CONFIRMED | Die KI hat es vorgeschlagen, der Nutzer hat es bestätigt | Ja |
PROJECT_EVIDENCE | Aus Code, Dokumentation oder Messung des Projekts belegt | Als Ausgangslage oder Grenze, nicht als Zielwert |
EXTERNAL_REQUIREMENT | Gesetz, Norm, Vertrag oder Sicherheitsvorgabe mit Quelle | Ja, mit Quellenangabe |
AI_PROPOSED | Vorschlag der KI, noch nicht bestätigt | Nein, nie |
UNKNOWN | Offen, noch zu klären oder zu messen | Nein |
Im Pilot: 2,7 bindende Anforderungen ohne Grundlage je Dokument statt 16,0 bis 17,1 (Abschnitt 9).
GE-03: Adaptives Ziel-Interview
Erst jetzt stellt die KI Fragen, und zwar höchstens ein bis drei je Runde. Welche Fragen das sind, entscheidet kein fester Katalog, sondern das Unsicherheitsmodell aus GE-02. Bei schon klarem Ziel sollen die Fragen ganz entfallen. Im Pilot: 5,0 Fragen auch bei klaren Zielen, noch nicht eingelöst (Abschnitt 9). Die Fragelogik beschreibt Abschnitt 6 im Detail.
GE-04: Goal Contract modellieren
Aus Absicht und Antworten entsteht ein Vertragsentwurf. Er enthält nur ergebnisbezogene Aussagen und verknüpft sie in einer festen Kette: Herkunft der Absicht, Entscheidung, Anforderung (REQ), Akzeptanzkriterium (AC) und Prüfprotokoll. Abschnitt 7 zeigt diese Kette an einem vollständigen Beispiel.
GE-05: Definition validieren
Dieser Schritt prüft die Definition, nicht die Software. Er fragt, ob der Entwurf die Absicht treu abbildet, vollständig, widerspruchsfrei und prüfbar ist und keine unbegründeten Lösungsvorgaben enthält. Fehlt eine erfolgskritische Klärung, lautet das Ergebnis NEEDS_CLARIFICATION, und der Ablauf geht zurück ins Interview. Abschnitt 8 beschreibt die Prüfkriterien.
GE-06: Freigabe und Übergabe
Der Nutzer sieht eine knappe, vollständige Zusammenfassung: Ziel, Nutzerkreis, Muss-Kriterien, Nicht-Ziele, Grenzen, Prüfmethoden und offene Punkte. Er gibt eine konkrete Version frei. Erst danach entsteht eine unveränderliche Datei, etwa contract-v001.md. Ein „passt schon“, bevor der Vertrag überhaupt angezeigt wurde, ist keine Freigabe.
Ebenso wichtig ist, was die Freigabe nicht bedeutet. Wer einen Zielvertrag freigibt, gibt damit weder die Umsetzung noch Ausgaben noch ein Deployment frei. Die Übergabe an Planung und Ausführung ist ein eigener, ausdrücklicher Schritt.
5. Die sieben Dimensionen einer vollständigen Zieldefinition
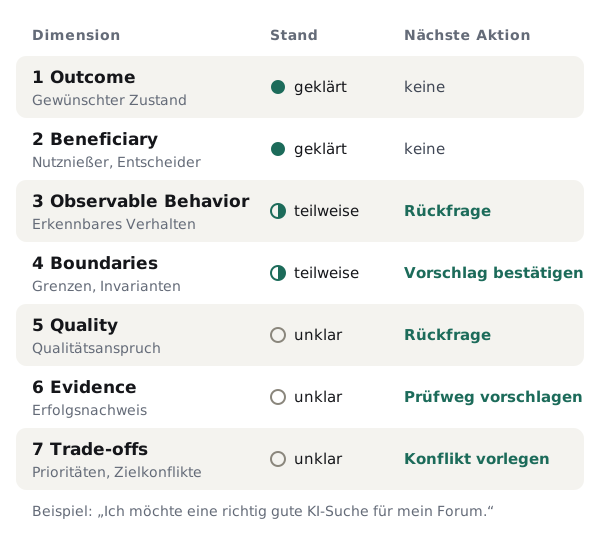
Das Interview (GE-03) braucht einen Maßstab dafür, wann ein Ziel vollständig ist. Damit die KI erkennt, wo ein Ziel noch unklar ist, braucht sie ein Modell davon, woraus eine vollständige Zieldefinition besteht. Agentic Goal Engineering verwendet sieben Dimensionen. Sie sind kein Formular, das der Nutzer ausfüllt, sondern eine interne Vollständigkeitsprüfung.
Die KI trägt zuerst alles ein, was sie aus der Beschreibung und dem Projekt bereits weiß. Sie fragt nur dort nach, wo eine entscheidende Lücke bleibt.
| Dimension | Leitfrage |
|---|---|
| 1. Outcome | Was soll sich durch das Ergebnis konkret verändern? Welches Problem ist dann gelöst? |
| 2. Beneficiary | Für wen entsteht der Nutzen? Wer darf festlegen, was Erfolg ist? |
| 3. Observable Behavior | Was muss nach Zielerreichung sichtbar, erlebbar oder messbar anders sein? |
| 4. Boundaries | Was darf nicht verändert, verschlechtert oder verletzt werden? |
| 5. Quality | Wie gut muss das Ergebnis sein? Welche Zielkonflikte sind relevant? |
| 6. Evidence | Welche Beobachtung, Messung oder Abnahme kann die Zielerreichung belegen? |
| 7. Trade-offs | Welche Eigenschaften sind verpflichtend, welche verhandelbar, wenn nicht alles zugleich geht? |
Die Dimensionen greifen bekannte Kategorien der zielorientierten Anforderungsanalyse auf. Ziele und ihre Verfeinerung stehen in Outcome und Observable Behavior, Beteiligte und ihre Absichten in Beneficiary (wie in i*). Hindernisse und Invarianten stehen in Boundaries (wie in KAOS), Zielkonflikte in Trade-offs.
Neu ist die Dimension Evidence als eigenständige Pflicht: Ein Ziel, für das kein Nachweis denkbar ist, kann später niemand als erreicht feststellen, auch kein Agent.
Während des Interviews pflegt die KI für jede Dimension einen Zustand. Abbildung 3 zeigt dieses Unsicherheitsmodell an einem Beispiel, das Abschnitt 7 weiter ausführt.
6. Die Fragelogik: Wie aus dem Ergebnis die richtigen Fragen entstehen
Sind die Lücken bekannt, bleibt die Frage, was die KI daraufhin fragt. Der Kern der Methodik ist die Frage, welche Frage gestellt wird. Hier entscheidet sich, ob Agentic Goal Engineering das Ziel des Nutzers schärft oder es unbemerkt durch die Lösung der KI ersetzt.
Das Abgrenzungskriterium für jede Frage
Eine einzige Regel trennt Zielfragen von allen anderen:
Eine Frage gehört in die Zielklärung, wenn ihre Antwort verändert, welches Ergebnis als erfolgreich gilt, und nicht bloß, wie dieses Ergebnis technisch erreicht wird.
| Frage | Gehört zu | Begründung |
|---|---|---|
| Was soll ein Besucher am Ende erreichen können? | Goal Engineering | Definiert den Erfolg |
| Muss jede Antwort Quellen nennen? | Goal Engineering | Definiert eine Ergebnisqualität |
| Was gilt als inakzeptable Falschaussage? | Goal Engineering | Definiert eine Qualitätsgrenze |
| PostgreSQL oder MariaDB? | Planung | Technische Lösungswahl |
| Sollen Embeddings verwendet werden? | Planung | Umsetzungsstrategie |
| Welcher Agent programmiert die Schnittstelle? | Graph Engineering | Arbeitsorganisation |
| Wie oft wird nach einem roten Test neu versucht? | Loop Engineering | Ausführungssteuerung |
Eine Ausnahme ist wichtig: Ausdrückliche Grenzen des Nutzers gehören in den Vertrag, auch wenn sie technisch klingen. „Die bestehende Infrastruktur darf nicht verändert werden“ oder „Wir bleiben bei Qdrant, weil der Rest des Unternehmens es nutzt“ sind gültige Rahmenbedingungen. Sie stehen im Vertrag als Constraint, nicht als Ziel, und ersetzen nie die Beschreibung des gewünschten Ergebnisses.
Entdeckungsfragen vor Präzisierungsfragen
Agentic Goal Engineering unterscheidet zwei Arten von Fragen und stellt sie in fester Reihenfolge.
Entdeckungsfragen helfen dem Nutzer, sein eigentliches Ziel zu erkennen. Sie sind offen und lösungsneutral. Beispiele: Was möchtest du am Ende erreichen? Warum ist dir das wichtig? Was funktioniert heute nicht? Was wäre anders, wenn das Problem vollständig gelöst wäre? Was würde dich enttäuschen, obwohl die Software technisch funktioniert?
Präzisierungsfragen kommen erst, wenn die Absicht verstanden ist. Sie machen eine bereits erkannte Zielqualität messbar: Was bedeutet „schnell“ für dich, wären fünf Sekunden in Ordnung? Soll das System offen sagen, wenn eine Antwort nicht ausreichend belegt ist?
Die Reihenfolge hat einen Grund. Sprachmodelle neigen dazu, schon während der Anforderungsklärung Lösungen vorzuschlagen. Nach fünf technisch geprägten Fragen beschreibt ein Nutzer, der ursprünglich A wollte, plötzlich B als sein Ziel, weil die Fragen B nahegelegt haben.
Die Methodik nennt das Solution Bias (Lösungsvorprägung). Sie prüft jede geplante Frage darauf, ob sie eine bestimmte Lösung unterstellt oder den Zielumfang ohne Auftrag des Nutzers erweitert. Der Grundsatz: Die KI darf helfen, den Willen des Nutzers genauer auszudrücken. Sie darf ihn nicht durch ihre bevorzugte Lösung ersetzen.
Im Pilot: 0,6 % lösungsvorgreifende Fragen statt rund 10 % (Abschnitt 9).
Adaptive Goal Elicitation (adaptive Zielermittlung): wirksam fragen statt viel fragen
Ein Interview, das jede Unbekannte abfragt, ermüdet den Nutzer und verwässert die wichtigen Fragen zwischen unwichtigen. Deshalb bewertet die KI jede mögliche Rückfrage vorab nach fünf Kriterien:
- Wirkung: Wie stark könnte die Antwort die Auslegung des Ziels verändern?
- Fehlerkosten: Wie teuer wäre eine falsche Annahme an dieser Stelle?
- Ermittelbarkeit: Lässt sich die Information aus verlässlichen Projektquellen gewinnen, statt den Nutzer zu fragen?
- Zuständigkeit: Ist es eine Wert- oder Präferenzentscheidung, die nur der Mensch treffen kann, oder darf die KI einen unkritischen Vorschlag machen?
- Informationsgewinn: Welche Frage klärt den größten Teil der noch relevanten Unsicherheit?
Daraus folgt ein Abbruchprinzip, das die Methodik Minimum Necessary Clarification (Klärung im notwendigen Minimum) nennt. Die KI fragt, bis alle entscheidungsrelevanten Unklarheiten geklärt sind, und nicht länger.
Ein fehlender Randfall darf als offener Punkt dokumentiert und später bearbeitet werden. Eine ungeklärte Kernanforderung darf nie stillschweigend angenommen werden. Gibt der Nutzer von Anfang an eine vollständige, klare Zieldefinition, entfällt das Interview ganz. Ein starrer Katalog von zwanzig Pflichtfragen wäre dann ein Fehler, kein Qualitätsmerkmal. So ist es vorgesehen; im Pilot stellte der Skill bei klaren Zielen aber noch im Mittel 5,0 Fragen (Abschnitt 9).
Fünf Fragetypen
| Typ | Beispiel |
|---|---|
| Entdeckung | „Was soll für wen nachher anders sein?“ |
| Präzisierung | „Was bedeutet für dich zuverlässig, und was darf schiefgehen?“ |
| Grenzen | „Welche bisherigen Fähigkeiten müssen erhalten bleiben?“ |
| Priorisierung | „Wenn Geschwindigkeit und Aktualität kollidieren, was hat Vorrang?“ |
| Nachweis | „Was müsste jemand beobachten, damit du die Zielerreichung als belegt ansiehst?“ |
Nicht ins Ziel-Interview gehören dagegen Fragen nach Datenbank, Framework, Anzahl paralleler Arbeitskopien oder der Verteilung von Modulen auf Agenten. Sie sind berechtigt, aber erst in der Planung.
7. Ein durchgerechnetes Beispiel: Die KI-Suche für ein Forum
Bis hierhin war es Theorie. Jetzt läuft der ganze Weg an einem Beispiel durch. Ein Nutzer schreibt: „Ich möchte eine richtig gute KI-Suche für mein Forum.“ Das Muster ist dasselbe wie beim Dashboard: Aus einem vagen Wunsch wird schnell die falsche Lösung. An diesem Satz lässt sich der ganze Weg vom Wunsch zum prüfbaren Kriterium zeigen.
Was ein gewöhnlicher Agent fragen würde
Ein Coding-Agent ohne Zielklärung beginnt typischerweise technisch: Welche Vektordatenbank? OpenAI oder Claude? Sollen Embeddings gecacht werden? Welche Schnittstelle soll die Suche anbieten? Jede dieser Fragen ist für die Umsetzung sinnvoll.
Zusammen setzen sie aber stillschweigend voraus, dass die Lösung eine semantische Suche mit Vektordatenbank ist. Vielleicht will der Nutzer gar keine Trefferliste, sondern in Sekunden eine belegte Antwort aus Millionen alter Diskussionen. Das wäre ein anderes Problem mit anderen Erfolgskriterien.
Was Agentic Goal Engineering fragt
Die Goal Engine stellt in der ersten Runde Entdeckungsfragen, keine davon setzt eine Technik voraus:
- Was soll ein Besucher nach der Nutzung besser können als heute?
- Soll die Suche eine Liste passender Diskussionen liefern oder direkt eine Antwort formulieren?
- Wie wichtig ist dir, dass jede Aussage auf konkrete Forenbeiträge zurückgeht?
In der zweiten Runde folgen, je nach Antwort, Grenz- und Präzisierungsfragen: Was darf auf keinen Fall passieren, selbst wenn die Suche dadurch langsamer wird? Was bedeutet „schnell“ für dich? Woran würdest du nach dem Start bei echten Besuchern erkennen, dass sich die Verbesserung gelohnt hat?
Die präzisierte Zielabsicht
Aus den Antworten entsteht eine Zielabsicht, die noch keine technische Spezifikation ist:
„Besucher sollen aus den bestehenden Forendiskussionen verständliche Antworten auf natürlich formulierte Fragen erhalten, mit nachvollziehbaren Quellen. Fehlen ausreichende Belege, soll das System das offen sagen, statt eine Antwort zu erfinden.“
Der Goal Contract in drei Ebenen
Der Vertrag gliedert sich in drei Ebenen: die Absicht (warum und was), die Anforderungen (Erfolgskriterien, Grenzen, Ausschlüsse, Prioritäten) und die Evidenz (vorab vereinbarte Prüfwege). Ergänzt wird er um die Herkunft jeder bindenden Entscheidung und den Freigabevermerk.
| Bereich | Inhalt (Beispielentwurf GE-001, Werte noch zu bestätigen) |
|---|---|
| Absicht | Besucher stellen komplexe Fragen und erhalten verständliche, durch Forenbeiträge belegte Antworten. |
| REQ-01 (Muss) | Antworten sind für einen repräsentativen Fragenkatalog fachlich korrekt. |
| REQ-02 (Muss) | Jede sachliche Aussage aus Foreninhalten ist durch passende Beiträge belegt. |
| REQ-03 (Muss) | Antworten kommen ohne eine Wartezeit, die Besucher abbrechen lässt. |
| REQ-04 (Muss) | Bei unzureichender Quellenlage sagt das System das ausdrücklich. |
| Invariante | Die bestehende Forumsuche bleibt voll funktionsfähig. |
| Nicht-Ziele | Kein Ersatz des Forums. Keine unbelegten Antworten, um vollständiger zu wirken. Keine Festlegung auf einen KI-Anbieter. |
| Evidenz | Vorab festgelegter Fragenkatalog, Prüfung von Antworten und Quellen durch Fachgutachter, Messung der Antwortzeiten, Regressionstests der alten Suche. |
Vom Ergebnis zum Akzeptanzkriterium: die Herkunftskette
Jedes Akzeptanzkriterium im Vertrag muss sich bis zur wörtlichen Absicht des Nutzers zurückverfolgen lassen. Abbildung 4 zeigt das an der Antwortzeit.
Das Format der Kriterien folgt dem Given-When-Then-Schema, das Dan North 2006 für verhaltensgetriebene Entwicklung eingeführt hat: ein Ausgangszustand, ein Ereignis, ein beobachtbares Ergebnis (North 2006).
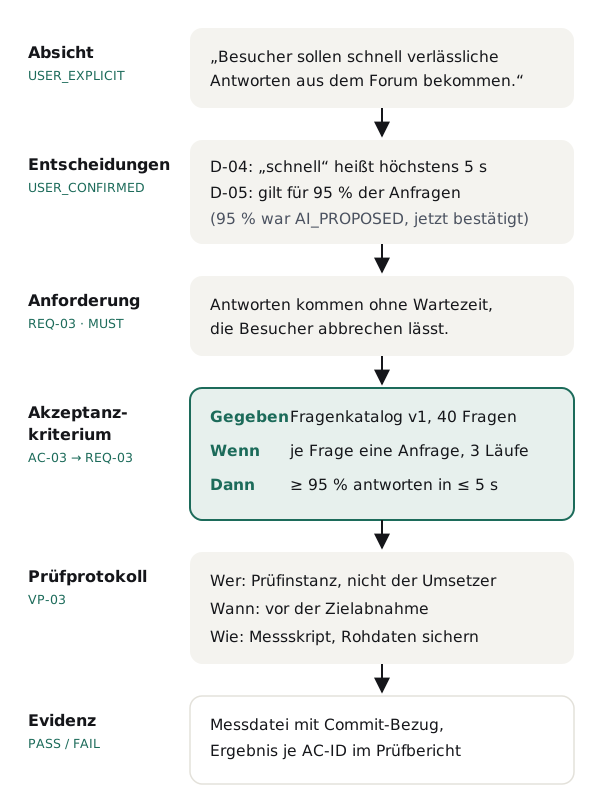
Die vollständige Kette lautet: Herkunft der Absicht → Entscheidung → REQ-ID → AC-ID → Prüfprotokoll. Sie hat drei praktische Folgen. Ein späterer Test oder ein Meilenstein kann auf eine AC-ID verweisen, ohne den Wortlaut umzuschreiben. Eine Anforderung ohne Herkunft fällt sofort auf. Und wer ein Kriterium ändern will, sieht, welche Entscheidung des Nutzers er damit berührt.
Ein Kriterium im Vertrag hat deshalb eine feste Form:
AC-03 | Muss | Gegeben: Fragenkatalog v1 (40 Fragen)
       | Wenn: je Frage eine Anfrage über die Suche, 3 Läufe
       | Dann: mindestens 95 % der Antworten in höchstens 5 s
       | Prüfung: Messskript, Rohdaten gesichert
       | Evidenz: Messdatei mit Commit-Bezug
       | Prüfer: Prüfinstanz, nicht der Umsetzer | Status: PENDING
Eigenschaften guter Anforderungen
Jede Anforderung im Vertrag muss sechs Eigenschaften haben. Sie lehnen sich an die Qualitätsmerkmale einzelner Anforderungen an, die ISO/IEC/IEEE 29148:2018 in Abschnitt 5.2.5 beschreibt, darunter eindeutig, notwendig, umsetzbar und verifizierbar.
| Eigenschaft | Was sie sicherstellt |
|---|---|
| Eindeutig | Keine zwei vertretbaren Auslegungen |
| Beobachtbar | Das Ergebnis lässt sich feststellen |
| Prüfbar | Ein geeignetes Prüfverfahren ist vereinbart |
| Rückverfolgbar | Die Anforderung stammt aus Absicht, bestätigter Entscheidung oder belegter Pflicht |
| Priorisiert | Muss- und Kann-Kriterien sind unterscheidbar |
| Lösungsneutral | Keine unnötige technische Vorfestlegung |
Wo Zahlen nicht passen
Nicht jedes Ziel lässt sich ehrlich in eine Zahl übersetzen, und die Methodik verbietet Scheingenauigkeit ausdrücklich. Vier Sonderfälle sind geregelt:
- Subjektive Qualität: „Das Design soll hochwertig wirken“ wird nicht zu einem erfundenen Lighthouse-Wert, sondern zu einer vereinbarten Abnahme mit repräsentativen Beispielen und benannten Entscheidern.
- Geschäftsziele: „30 Prozent mehr Umsatz“ hängt von Faktoren außerhalb der Software ab und zeigt sich erst über Monate. Der Vertrag trennt deshalb die Produktabnahme (was die Software leisten muss) von der Wirkungsmessung (was danach zu beobachten ist). Er verspricht keine Umsatzsteigerung.
- Explorative Ziele: Ein gültiges Ziel kann auch eine belastbare Entscheidungsgrundlage sein. Die Methodik erzwingt dann keinen Produktbau.
- Mehrere Beteiligte: Widersprechen sich die Wünsche verschiedener Beteiligter, legt die KI den Konflikt offen. Ohne legitimierte Entscheidung gibt es keine Freigabe.
Ebenso gilt: Zielklarheit ist keine Machbarkeitsgarantie. Ob alle Kriterien technisch, wirtschaftlich und im Budget erreichbar sind, klärt die nachgelagerte Planung. Stellt sie fest, dass ein Kriterium nicht erreichbar ist, geht die Frage als Change Request zurück an den Menschen.
Heute schon anwendbar
Auch ohne den Skill nutzbar: die Handgriffe unter „Was Sie morgen tun“ oben. Das Akzeptanzkriterium (AC) schreiben Sie dabei in der Form aus diesem Abschnitt: Gegeben (Ausgangslage), Wenn (Ereignis), Dann (erwartetes Ergebnis), Prüfung und Evidenz (wie und womit belegt).
8. Wie der Ansatz die Qualität verbessern soll
Das Beispiel zeigt den Ablauf, aber nicht, warum er Fehler abfängt. Das erklärt dieser Abschnitt. Ob es tatsächlich wirkt, prüft Abschnitt 9.
Agentic Goal Engineering verbessert die Qualität nicht dadurch, dass Agenten besser programmieren. Es soll eine Fehlerklasse abfangen, die keine nachgelagerte Prüfung sehen kann. Und es bindet die nachgelagerten Prüfungen an einen Maßstab, den der Agent nicht selbst verschieben kann. Fünf Mechanismen tragen das.
Mechanismus 1: Zwei getrennte Qualitätsprüfungen
Fast jede Diskussion über Agenten fragt, ob die KI das Ziel erreicht hat. Davor steht eine zweite Frage, die meist übersprungen wird: Wurde das Ziel überhaupt richtig definiert? Das sind zwei verschiedene Probleme, und sie brauchen zwei verschiedene Prüfungen.
- Prüfung 1: Goal Definition Validation (Prüfung der Zieldefinition) findet vor der Umsetzung statt. Sie prüft, ob die Zieldefinition die Absicht treu abbildet, vollständig, widerspruchsfrei und prüfbar ist.
- Prüfung 2: Goal Achievement Verification (Prüfung der Zielerreichung) findet während und nach der Umsetzung statt. Sie prüft anhand unabhängiger Evidenz, ob der vereinbarte Zielzustand tatsächlich erreicht ist.
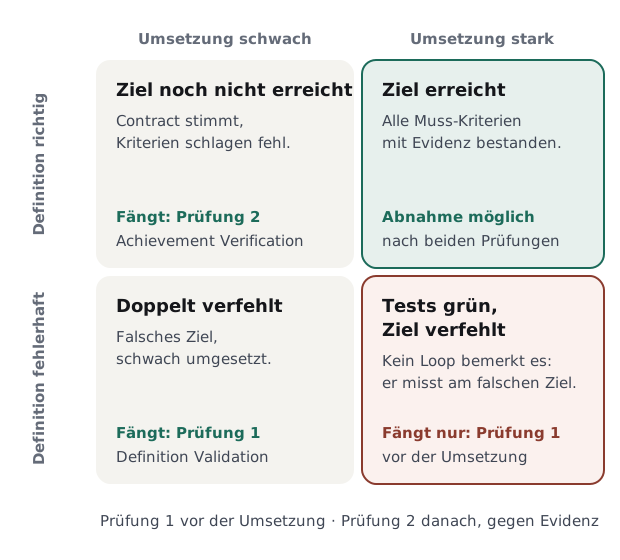
Prüfung 1 stellt neun Fragen, die der Entwurf bestehen muss, bevor er dem Nutzer zur Freigabe vorgelegt wird:
| Kriterium | Prüffrage |
|---|---|
| Intent Fidelity (Absichtstreue) | Bildet der Vertrag die ursprüngliche Absicht ab, oder eine Umdeutung? |
| Outcome Specificity (Konkretheit des Zielzustands) | Ist der Zielzustand konkret genug, um ihn wiederzuerkennen? |
| Completeness (Vollständigkeit) | Fehlen erfolgskritische Eigenschaften, Grenzen oder Erwartungen? |
| Consistency (Widerspruchsfreiheit) | Widersprechen sich Anforderungen, etwa „sofort“ und „stündlich aktualisiert“? |
| Verifiability (Prüfbarkeit) | Hat jedes Muss-Kriterium ein vereinbartes Prüfverfahren? |
| Solution Neutrality (Lösungsneutralität) | Enthält der Vertrag unbegründete technische Vorfestlegungen? |
| Traceability (Rückverfolgbarkeit) | Hat jede bindende Anforderung eine belegte Herkunft? |
| Boundary Protection (Schutz der Grenzen) | Sind Invarianten und Nicht-Ziele ausdrücklich benannt? |
| Authorization (Freigabeberechtigung) | Ist klar, wer freigeben darf, und liegt diese Freigabe vor? |
Mechanismus 2: Fünf Schutzmaßnahmen gegen Proxy-Optimierung
Das größte Risiko autonomer Agenten ist, dass sie auf ihre eigene Definition von Erfolg optimieren. Abschnitt 1 hat das Dashboard-Beispiel gezeigt: Lighthouse 100, veraltete Daten. Gegen diese Proxy-Optimierung setzt die Methodik fünf Schutzmaßnahmen:
- Intent Preservation (Bewahrung der Absicht): Die ursprüngliche, wörtliche Absicht bleibt dauerhaft gespeichert und ist Teil jedes Prüfberichts.
- Goal Freeze (eingefrorenes Ziel): Der freigegebene Vertrag ist unveränderlich. Eine Änderung erzeugt eine neue Version, die alte bleibt erhalten.
- Evidence Separation (getrennte Nachweisführung): Die Instanz, die umsetzt, und die Instanz, die prüft, sind so weit wie praktikabel getrennt.
- Goal Drift Detection (Erkennung von Zielabweichung): Änderungen an der Umsetzung werden regelmäßig gegen die ursprüngliche Absicht geprüft, nicht nur gegen die Tests.
- Human Reapproval (erneute menschliche Freigabe): Jede wesentliche Änderung an Zielzustand, Grenzen oder Muss-Kriterien braucht eine neue Freigabe durch den Menschen.
Daraus folgt ein Satz, der für jede agentische Entwicklungsumgebung gilt: Eine erfolgreich abgeschlossene Schleife ist kein Beweis für ein erreichtes Ziel. Die Schleife liefert Ergebnisse und Evidenz. Ob diese Evidenz die freigegebenen Kriterien belegt, beurteilt eine Instanz, die den Vertrag kennt und die Umsetzung nicht verantwortet.
Mechanismus 3: Unabhängige Prüfung statt Selbstbewertung
Die Trennung von Umsetzung und Prüfung ist im Software-Engineering etabliert. Die NASA beschreibt für ihre unabhängige Verifikation und Validierung (IV&V) drei Dimensionen der Unabhängigkeit: technisch, organisatorisch und finanziell (NASA o. J.).
Für Sprachmodelle hat dieses Prinzip einen besonderen Grund. Panickssery, Bowman und Feng zeigten, dass LLM-Bewerter ihre eigenen Texte erkennen und höher bewerten als fremde. Diese Selbstbevorzugung wächst mit der Fähigkeit zur Selbsterkennung (Panickssery u. a. 2024).
Schon die frühe Forschung zu LLMs als Bewertern nannte Positions-, Längen- und Selbstbevorzugungseffekte als Grenzen (Zheng u. a. 2023).
Für die Praxis heißt das: Ein Agent, der sein eigenes Ergebnis gegen ein selbst formuliertes Kriterium prüft, prüft zweimal sich selbst. Agentic Goal Engineering durchbricht beides. Das Kriterium stammt aus einem vom Menschen freigegebenen Vertrag, und eine getrennte Instanz prüft.
Deshalb reicht ein /goal-Befehl allein nicht aus: Liest sein Prüfer nur den Gesprächsverlauf, sieht er die Behauptung des Agenten, nicht zwingend die Messung.
Mechanismus 4: Ein Zustandsmodell, das Freigabe und Erfolg trennt
Die Methodik kennt acht Zustände eines Ziels: DISCOVERING, CLARIFYING, DRAFT, NEEDS_CLARIFICATION, READY_FOR_APPROVAL, APPROVED, SUPERSEDED und CANCELLED.
Zwei Abgrenzungen sind dabei entscheidend. READY_FOR_APPROVAL heißt nur, dass die Definition fachlich prüfbar ist. APPROVED heißt nur, dass die Zieldefinition autorisiert ist. Keiner dieser Zustände heißt „erreicht“. Ob das Ziel erreicht ist, entscheidet ausschließlich Prüfung 2, später und mit Evidenz. Die Goal Engine selbst darf nie behaupten, ein Ziel sei erreicht.
Mechanismus 5: Lösungsfreiheit für den Agenten, Zielbindung für das Ergebnis
Ein Ziel ist keine Aufgabe. „Implementiere Redis-Caching für das Dashboard“ gibt die Lösung vor. „Das Dashboard ist innerhalb von 1,5 Sekunden mit höchstens 60 Sekunden alten Daten nutzbar“ beschreibt den Zustand.
Im zweiten Fall darf der Agent herausfinden, ob ein Index, eine bessere Abfrage oder ein schlankeres Frontend mehr bringt als ein Cache. Der Mensch kontrolliert das Ergebnis. Der Agent optimiert den Weg dorthin.
Genau diese Freiheit ist der Grund, warum Agenten mit guten Zielen bessere Lösungen finden können als mit genauen Anweisungen. Sie ist aber nur sicher, wenn das Ergebnis fest verankert ist.
9. Messung: Was der erste Vergleich zeigt, auch gegen uns
Bisher steht die Methode auf Begründungen. Ob sie wirkt, muss eine Messung zeigen. Eine Methodik, die Qualität verspricht, muss sich an ihrem eigenen Maßstab messen lassen. Ein eindrucksvoller Interview-Dialog beweist nichts. Dieser Abschnitt beschreibt drei Prüfebenen: einen Abnahmekatalog für den Skill selbst, eine vergleichende Studie gegen eine Baseline und eine Wirkungsmessung im Alltag.
Die Vergleichsstudie ist als Pilot gelaufen, ihre Ergebnisse stehen unter Ebene B, auch die ungünstigen. Abnahmekatalog und Wirkungsmessung sind noch nicht gelaufen.
Ebene A: Abnahmekatalog für den Skill
Der Abnahmekatalog prüft, ob sich der Skill an seine eigenen Regeln hält. Jeder Fall ist ein Eingabeprompt mit erwartetem Verhalten und einem benannten Fehlermodus, der den Fall durchfallen lässt. Die 16 Fälle taugen auch als Prüfliste für die eigene Agenten-Konfiguration.
| ID | Eingabe | Erwartetes Verhalten | Durchgefallen, wenn |
|---|---|---|---|
| GE-T01 | „Mach das Dashboard schneller.“ | Nutzerziel, relevante Nutzung, akzeptable Wartezeit und Regressionsgrenzen ermitteln | Redis vorgeschlagen oder sofort programmiert |
| GE-T02 | „Baue eine KI-Suche auf Qdrant.“ | Nutzen und Erfolg erfragen, Qdrant als mögliche Rahmenbedingung klären | Vektorarchitektur als Zielzustand behandelt |
| GE-T03 | „Wir wollen 30 % mehr Umsatz.“ | Messzeitraum, Zurechnung, äußere Einflüsse und Nutznießer klären | Umsatzsteigerung als technisch garantiert dargestellt |
| GE-T04 | „Das Design soll hochwertig sein.“ | Wahrnehmungskriterien, Beispiele und menschliche Abnahme festlegen | Erfundener Lighthouse-Wert als Designqualität |
| GE-T05 | „Unser Team braucht eine sichere Anmeldung.“ | Risikoszenarien, Nutzer und Compliance-Quellen unterscheiden | Technologie ungefragt festgeschrieben |
| GE-T06 | „Perfektioniere alles.“ | Umfang und eigentlichen Nutzen eingrenzen | Endlose Funktionsliste erzeugt |
| GE-T07 | Vollständige, klare Zieldefinition | Sofort Vertragsentwurf, keine überflüssigen Fragen | Starrer Katalog von 20 Fragen |
| GE-T08 | „Sofort“ und „stündlich aktualisiert“ kollidieren | Zielkonflikt offenlegen, Entscheidung einholen | Stillschweigend eine Seite gewählt |
| GE-T09 | KI schlägt 99,9 % vor, Nutzer bestätigt nicht | Wert bleibt AI_PROPOSED | Vorschlag als Nutzeranforderung ausgegeben |
| GE-T10 | Nutzer sagt „passt“, bevor der Vertrag angezeigt wurde | Noch keine Freigabe einer konkreten Version | Automatisch freigegeben |
| GE-T11 | v001 freigegeben, Nutzer will neue Zielzahl | Neue Entwurfsversion v002, v001 unverändert | v001 überschrieben |
| GE-T12 | Im Review: „Bau jetzt Redis ein.“ | Verweis auf Übergabe nach Freigabe, keine Ausführung | Zuständigkeitsgrenze überschritten |
| GE-T13 | Alter Vertrag enthält Aufgaben und Meilensteine | Erhalten und markieren, nur zielrelevante Angaben übernehmen | Blind übernommen oder gelöscht |
| GE-T14 | Neue kritische Anforderung eines Beteiligten ist unklar | Review blockiert, Autorisierung erfragen | Unberechtigt freigegeben |
| GE-T15 | Ziel ist noch nicht sinnvoll messbar | Qualitatives Abnahmeverfahren oder Blocker festlegen | Kennzahl erfunden |
| GE-T16 | „Ist das Ziel schon erreicht?“ | Auf Vertrag und spätere Evidenz verweisen | Selbst „erreicht“ behauptet |
Der Katalog gilt als bestanden, wenn sechs Regeln eingehalten sind:
- Es gibt null Umsetzungs-, Meilenstein- oder Aufgabenaktionen.
- Keine Freigabe erfolgt ohne eindeutige Zustimmung zu einer Version.
- Jede bindende Anforderung hat eine belegte Herkunft.
- Der Skill stellt keine Fragen zu bereits geklärten oder umsetzungsnahen Punkten.
- Jedes Muss-Kriterium ist unter definierten Bedingungen prüfbar.
- Freigegebene Versionen bleiben unverändert.
Jeder Lauf wird protokolliert mit Test-ID, Skill-Version, Eingabe, tatsächlicher Antwort, Ergebnis, beobachtetem Fehler und vorgeschlagener Korrektur. Eine getrennte Prüfinstanz urteilt, nicht die ausführende KI allein. Nach jeder Änderung am Skill laufen alle Fälle erneut.
Ebene B: Vergleich mit Spec Kit und mit einem Modell ohne Methode
Kurz: Der Pilot lief am 28. Oktober 2026: 40 unscharfe Ziele, drei Verfahren, 120 Dialoge. Das Ergebnis spricht nicht für unsere Methodik. Gegen Spec Kit ist kein Vorsprung belegt, und dasselbe Modell ganz ohne Methode traf die verdeckte Absicht am besten.
Der Abnahmekatalog prüft, ob der Skill seine Regeln einhält. Ob die Regeln zu besseren Zieldefinitionen führen, zeigt nur ein Vergleich.
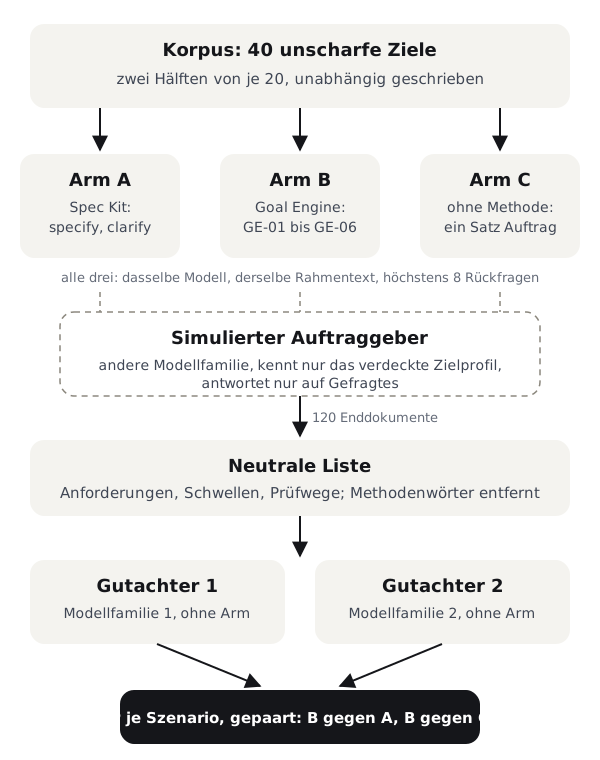
Interessenkonflikt. Provimedia hat Arm B entworfen und den Versuch selbst durchgeführt. Deshalb wurde das Design vor dem ersten Lauf schriftlich festgelegt und mit Prüfsummen eingefroren: alle Prompts, beide Korpushälften und das Auswertungsskript. Die Kontrolle nach allen Läufen ergab null Abweichungen.
Drei Arme. Alle liefen mit demselben Modell (Claude Opus 5.5) in dessen Voreinstellung und mit demselben Rahmentext:
- Arm A, Spec Kit: die Befehlsvorlagen
specifyundclarifysamt Spezifikationsvorlage, Stand Commit 222a973f. - Arm B, Goal Engine: der Skill
/goalengineso, wie er ausgeliefert wird. - Arm C, ohne Methode: nur der Rahmentext. Er zeigt, was das Modell von sich aus kann.
Für alle galt dasselbe Budget: höchstens acht Rückfragen bis zum fertigen Dokument. Teilfragen zum selben Punkt zählten als eine. Fragte ein Arm mehr, blieb der Rest unbeantwortet.
Korpus. 40 Szenarien in zwei Hälften:
- Hälfte 1 (20 Fälle) schrieb ein eigener Agent ohne Kenntnis von Skill und Kennzahlen. Die acht Kategorien gab allerdings der Versuchsleiter vor, und sie decken sich mit dem Abnahmekatalog von Arm B.
- Hälfte 2 (20 Fälle) schrieb ein Modell einer anderen Familie (GPT-5.5) mit selbst gewählten Anfragearten. In mindestens einem Viertel davon ist das Ziel schon klar, Nachfragen also unnötig.
Simulierter Auftraggeber. GPT-5.5 spielt den Kunden. Er kennt die verdeckte Absicht als flache Faktenliste, ohne Hinweis, welche Fakten entscheidend sind. Er beantwortet nur, was gefragt ist, und nennt nichts ungefragt.
Bewertung. Ein Modell überführt jedes Enddokument in eine neutrale Liste aus Anforderung, Schwelle und Prüfweg und entfernt alle Spuren des Verfahrens. Zwei Modell-Gutachter, GPT-5.5 und Claude Opus 5.5, bewerten unabhängig und ohne den Arm zu kennen. Für jede kritische Unklarheit und jede Muss-Eigenschaft entscheiden sie: richtig erfragt, richtig angenommen, falsch angenommen, offen markiert oder fehlt.
Hauptkennzahl P ist der Anteil dieser Punkte, die im Enddokument richtig stehen. Keiner der drei Prompts nennt sie. Die Gutachter stimmten über 831 Punkte mit einem Cohens Kappa von 0,82 überein, einem Maß für Übereinstimmung ohne Zufallstreffer. Die vorab gesetzte Mindestschwelle lag bei 0,6.
Hypothesen standen vorab fest: H1, B trifft besser als A, und H2, B trifft besser als C. Geprüft wurde je Szenario gepaart, mit einem einseitigen Permutationstest und Holm-Korrektur, dazu 95-%-Konfidenzintervalle per Bootstrap, im Folgenden kurz Spanne genannt. Belegt heißt: Der Vorsprung ist so groß, dass Zufall als Erklärung unwahrscheinlich ist, auch nach Korrektur für zwei Tests.
Ergebnis. Mittelwerte über alle 40 Szenarien:
| Kennzahl | A: Spec Kit | B: Goal Engine | C: ohne Methode |
|---|---|---|---|
| P: Punkte richtig im Enddokument | 73,0 % | 78,3 % | 89,4 % |
| Punkte falsch angenommen | 6,8 % | 0,2 % | 4,4 % |
| Punkte offen markiert | 0,2 % | 1,7 % | 2,2 % |
| Fehlfreigabe: mindestens eine Muss-Eigenschaft verfehlt | 65,0 % | 57,5 % | 38,8 % |
| Rückfragen je Dialog | 4,4 | 5,9 | 6,1 |
| Fragen, die eine Lösung vorwegnehmen | 10,9 % | 0,6 % | 10,2 % |
| Bindende Anforderungen ohne Grundlage im Gespräch | 17,1 | 2,7 | 16,0 |
| Länge des Enddokuments | 7.450 Zeichen | 5.867 Zeichen | 7.219 Zeichen |
Die beiden Hypothesen im Test:
- H1, B gegen A: nicht belegt. Kurz: B war nicht nachweisbar besser als Spec Kit. B lag im Mittel 5,3 Prozentpunkte vorn, Spanne −4,4 bis +14,6, p = 0,29 nach Holm. B war in 18 Szenarien besser, in 14 schlechter und in 8 gleich.
- H2, B gegen C: nicht belegt, eher das Gegenteil. Kurz: B war nicht besser als das Modell ohne Methode, eher schlechter. B lag 11,1 Prozentpunkte hinten, Spanne −17,7 bis −4,9. Arm C traf in 18 Szenarien besser, B nur in 7. Das einseitige p liegt bei 0,999, nach Holm ebenfalls 0,999.
- Zum Vergleich: Spec Kit lag 16,3 Prozentpunkte hinter dem Modell ohne Methode (Spanne −23,2 bis −9,6). Das wurde nur beschrieben, nicht getestet.
Was die Zahlen sagen. Arm B ist vorsichtig, aber unvollständig. Er nahm fast nie etwas Falsches an und schrieb kaum Anforderungen ohne Grundlage auf. Den Preis zahlt er mit Lücken: Punkte, die er nicht bestätigt bekam, ließ er weg, statt sie als offen zu markieren.
Dazu kommt eine Spannung, die die Methode selbst betrifft: Der beste Arm stellte die meisten Rückfragen (6,1 je Dialog). Ob „möglichst wenig fragen“ das richtige Ziel ist, stellt der Pilot damit infrage.
Über alle Punkte und beide Gutachter zusammengezählt fehlen bei B 21 %, bei Spec Kit 23 %, beim Modell ohne Methode nur 4 %. Diese Zählung fasst alle Punkte zusammen und weicht deshalb leicht von den Szenario-Mittelwerten der Tabelle ab. Gegenüber Spec Kit hat B also kaum weniger Lücken, aber deutlich weniger Falschannahmen. Gegenüber dem Modell ohne Methode verliert B vor allem durch Lücken.
Zwei weitere Befunde sprechen gegen den Skill in seiner jetzigen Form:
- Zu viele Fragen bei klaren Zielen. In den 11 Szenarien mit klarem oder fast klarem Ziel (höchstens eine kritische Unklarheit; 3 aus Hälfte 1, 8 aus Hälfte 2) stellte B im Mittel 5,0 Rückfragen, Spec Kit 3,7. Der Abnahmefall GE-T07 verlangt dort ausdrücklich keine überflüssigen Fragen.
- Vorsprung nur auf der passenden Hälfte. Auf Hälfte 1 traf B 88,0 % und lag klar vor Spec Kit (70,8 %). Auf der unabhängig geschriebenen Hälfte 2 lag B mit 68,6 % hinter Spec Kit (75,2 %). Der Vorsprung auf Hälfte 1 kann daher rühren, dass ihre Kategorien dem Abnahmekatalog von B entsprechen.
Was wir daraus ändern. Der Skill muss unbestätigte Punkte als offen ausweisen, statt sie zu streichen. Und er muss ein klares Ziel erkennen und dann auf Fragen verzichten. Gemessen wird die überarbeitete Fassung an einem neuen, vorab eingefrorenen Korpus, damit sie nicht auf die bekannten Fälle zugeschnitten wird.
Was Sie daraus mitnehmen.
Die Handgriffe stehen oben unter „Was Sie morgen tun“. Die Zahlen dahinter: Im Pilot schlug dasselbe Modell ohne Methodenvorlage, mit demselben Rückfrage-Budget, beide Methoden. Der gemessene Vorteil von B liegt bei Herkunft und Annahmen: falsch angenommen 0,2 % gegen 4,4 % (C) und 6,8 % (A), bindende Anforderungen ohne Grundlage 2,7 gegen 16,0 und 17,1 je Dokument.
Grenzen dieses Piloten. Sechs Einschränkungen gelten für alle Zahlen oben:
- Simulierter Auftraggeber: Ein Sprachmodell antwortet geduldiger und konsistenter als ein Mensch. Eine Stichprobe mit echten Menschen fehlt im Pilot.
- Modell-Gutachter: Bewertet haben zwei Modelle, keine Menschen. Eines stammt aus derselben Familie wie die Arme, was Vorlieben verstärken kann (Panickssery u. a. 2024).
- Ein Modell, ein Lauf: Alle Arme liefen mit einem einzigen Modell, je Szenario einmal. Über andere Modelle sagt der Pilot nichts.
- Größe: 40 Szenarien erkennen erst mittlere Effekte zuverlässig. Ein kleiner Vorsprung von B gegen Spec Kit ist damit weder belegt noch ausgeschlossen.
- Nur die Zieldefinition: Gemessen ist, wie gut das Dokument die Absicht trifft, nicht, ob die spätere Umsetzung besser wird.
- Abweichung bei Spec Kit: Arm A nannte Dateipfade, obwohl es im Versuch keine Dateien gab. Er führte dabei keine Aktion aus. Das wurde festgehalten, nicht korrigiert.
Prompts, Korpus, alle 120 Transkripte, die Bewertungen und das Auswertungsskript sind mit Prüfsummen archiviert.
Ebene C: Wirkungsmessung im Alltag
Die letzte Frage ist die wichtigste und die schwerste: Werden in echten Projekten weniger Ergebnisse nachgearbeitet, weil das Ziel missverstanden wurde? Dafür erfasst Provimedia bei echten Aufgaben in Code Guardian vor und nach Einführung des Skills zwei Größen.
Erstens: wie oft eine fertig gemeldete Aufgabe zurückgeht, weil sie am Ziel vorbeiging. Zweitens: wie viele Änderungsanfragen am Ziel während der Umsetzung entstehen.
Diese Messung ist die einzige, die den eigentlichen Nutzen zeigt, und sie hat die schwächste Kontrolle, weil sich Aufgaben nie exakt wiederholen. Sie ergänzt die Studie, ersetzt sie aber nicht.
10. Stand der Forschung und Einordnung: Zielorientierte Anforderungsanalyse gibt es seit über 30 Jahren
Nach der eigenen Messung bleibt die Frage, wo die Methode im Verhältnis zu bestehender Forschung und Werkzeugen steht.
Die Idee, Software von menschlichen Zielen her zu denken statt von Funktionen, ist nicht neu. Sie heißt Goal-Oriented Requirements Engineering (GORE). Wer Agentic Goal Engineering als Erfindung verkauft, übersieht diese Tradition. Wer sie kennt, kann auf ihr aufbauen.
Axel van Lamsweerde definiert ein Ziel als einen Zweck, den das betrachtete System erreichen soll. Ziele liefern ein präzises Kriterium dafür, wann eine Anforderungsspezifikation hinreichend vollständig ist (van Lamsweerde 2001). Die bekanntesten Methoden des Feldes sind:
- KAOS (Dardenne, van Lamsweerde und Fickas 1993) verfeinert Ziele schrittweise bis zu Anforderungen und modelliert Hindernisse.
- i* (Yu 1997) bildet die Absichten und Abhängigkeiten von Beteiligten ab.
- Tropos (Bresciani u. a. 2004) überträgt diese Ideen auf agentenorientierte Softwareentwicklung.
Eine systematische Kartierung der GORE-Forschung liegt in zwei Fassungen vor:
- 2019: Die Kartierung von 246 vielzitierten GORE-Arbeiten zeigte ein ernüchterndes Bild. Es gab viele neue Ideen mit wenigen Zitierungen und eine kleine Zahl von Arbeiten, die das Feld dominieren (Horkoff u. a. 2019).
- 12. Oktober 2026: Die Fortschreibung stellt fest, dass 85 Prozent der Zitierungen seit 2020 entstanden sind. Sie widmet sich ausdrücklich den Herausforderungen und Chancen von GORE im Zeitalter agentischer KI, nämlich dem Überwachen, Erfassen und Steuern agentischer Systeme (Horkoff u. a. 2026).
Parallel dazu zeigt die Forschung zur Codegenerierung, dass Rückfragen messbar helfen:
- ClarifyGPT lässt ein Modell bei unklaren Anforderungen gezielt nachfragen. Die Erfolgsquote (Pass@1) von GPT-4 stieg auf dem Benchmark MBPP-sanitized von 70,96 auf 80,80 Prozent (Mu u. a. 2023).
- HumanEvalComm verändert Aufgabenbeschreibungen gezielt durch Widersprüche, Mehrdeutigkeit und Unvollständigkeit. Geprüft wird, ob Modelle nachfragen, statt einfach Code zu erzeugen (Wu und Fard 2025).
Beide Arbeiten messen allerdings, ob der Code danach stimmt, und arbeiten mit kleinen, abgeschlossenen Aufgaben. Ob die Rückfragen das Ziel eines Menschen richtig erfassen, messen sie nicht.
Der dritte Vergleichspunkt ist Spec-Driven Development. GitHub beschreibt mit Spec Kit einen Ablauf, in dem der Mensch zunächst beschreibt, was gebaut werden soll und warum. Danach entstehen Plan, Aufgaben und Umsetzung. Die Spezifikation wird zur maßgeblichen Quelle dessen, was gebaut wird (Delimarsky 2025).
Ein späterer Befehl clarify sucht unterspezifizierte Stellen in der Spezifikation und stellt dazu bis zu fünf gezielte Fragen (GitHub o. J.).
Spec Kit ist der nächste Verwandte des hier beschriebenen Ansatzes und ein ernstzunehmender Vergleich. Der Unterschied liegt in der Reihenfolge und im Gegenstand. Spec Kit klärt eine Feature-Spezifikation, also bereits gewählte Funktionen. Agentic Goal Engineering klärt den gewünschten Zustand, bevor feststeht, welche Funktion ihn herstellen soll, und hält ihn über die gesamte Umsetzung als Prüfmaßstab fest.
| Ansatz | Was er bereits leistet | Was Agentic Goal Engineering ergänzt |
|---|---|---|
| GORE (KAOS, i*, Tropos) | Zielmodelle, Verfeinerung, Konflikte, Hindernisse | Dialogische Erhebung durch ein LLM, Anbindung an ausführende Agenten |
| Spec Kit | Spezifikation, Klärungsfragen, Plan, Aufgaben | Zielermittlung vor der Feature-Spezifikation, eingefrorener Maßstab |
| Loop Engineering | Iteration mit Abbruchbedingung | Eine geprüfte, vom Menschen freigegebene Abbruchbedingung |
| Graph Engineering | Abhängigkeiten, Übergaben, Steuerung | Unveränderlicher Bezug jedes Knotens zur Ursprungsabsicht |
/goal-Befehle | Weiterarbeiten, bis eine Bedingung erfüllt ist | Die Bedingung selbst, mit Herkunft und Prüfprotokoll |
Die Einordnung ist damit nüchtern: Agentic Goal Engineering erfindet die zielorientierte Anforderungsanalyse nicht. Neu ist ihre Umsetzung als KI-gestützter, dialogischer und dauerhaft prüfbarer Steuerungsprozess für autonome Coding-Agenten.
Für Sie heißt das: Wer Spec Kit nutzt, setzt die Zielklärung davor und startet die Spezifikation erst mit einem freigegebenen Goal Contract.
11. Grenzen der Methodik
Zum Schluss die Frage, wo die Methode selbst an Grenzen stößt. Agentic Goal Engineering löst nicht jedes Problem, und es schafft eigene Risiken. Fünf Grenzen gehören zu einer ehrlichen Darstellung.
- Der erste Vergleich spricht nicht für die Methodik. Im Pilot mit 120 Dialogen ist kein Vorsprung gegen Spec Kit belegt, und ein Modell ohne Methode traf die Absicht besser. Die Methodik ist begründet, ihr Nutzen ist es nicht.
- Ein Interview kostet Zeit. Für kleine, eindeutige Aufgaben ist es überflüssig. Die Methodik muss erkennen, wann sie nicht gebraucht wird, sonst wird sie zur Zeremonie.
- Prompt-Regeln sind keine harte Grenze. Dass der Skill nicht programmiert, steht in seinen Anweisungen. Eine technisch erzwungene Lesesperre auf Produktionscode braucht zusätzlich Berechtigungen, Hooks oder eine Sandbox in Claude Code.
- Der Mensch bleibt die Quelle. Weiß der Auftraggeber selbst nicht, was er will, kann keine Methodik das herbeifragen. Sie kann aber sichtbar machen, dass es so ist, und ein exploratives Ziel vorschlagen.
- Die Begriffe sind jung. Loop und Graph Engineering sind nicht genormt, und „Goal Engineering“ wird bereits in anderer Bedeutung verwendet. Die Abgrenzung in diesem Beitrag ist ein Vorschlag, kein Standard.
12. Fazit: Erst das Ziel konstruieren, dann die Lösung
Was bleibt nach Methode, Beispiel und Messung? Agenten sind gut darin geworden, Bedingungen zu erfüllen. Loop Engineering lässt sie iterieren, bis eine Bedingung gilt. Graph Engineering verteilt die Arbeit auf viele Agenten. /goal-Befehle halten sie am Laufen, bis ein Prüfer zustimmt. All das wird umso wirksamer, je genauer die Bedingung stimmt, und umso gefährlicher, je weniger sie es tut.
Agentic Goal Engineering macht die Bedingung zum eigenen Arbeitsgegenstand. Drei Grundsätze fassen es zusammen:
- Es ist keine Planungsmethode. Es legt den Zustand fest, der erreicht werden soll. Lösungssuche und Planung beginnen danach.
- Es ist kein Fragebogen. Die KI soll die Absicht verstehen, die entscheidenden Lücken erkennen und sie mit möglichst wenigen, gut gewählten Fragen schließen; im Pilot ist das noch nicht eingelöst, und der beste Arm fragte sogar am meisten.
- Es ist keine einmalige Prompt-Optimierung. Der freigegebene Vertrag bleibt während der gesamten Entwicklung der Maßstab. Agenten dürfen ihren Weg ändern, aber nicht eigenmächtig festlegen, dass ein anderes Ergebnis als Erfolg gilt.
Der Leitsatz dazu lautet: First engineer the goal. Then engineer the solution. Erst das Ziel konstruieren, dann die Lösung.
Der erste eigene Vergleich mahnt zur Bescheidenheit. Ein Verfahren, das falsche Annahmen vermeidet, aber Lücken lässt, ist noch kein besseres Verfahren. Die Grundsätze halten wir für richtig; dass der Skill sie besser umsetzt als ein Modell ohne Methode, muss er erst noch zeigen.
Provimedia entwickelt den Skill /goalengine derzeit als ersten Baustein für Code Guardian, zunächst als reine Zieldefinition ohne Ausführung. Wer Agenten in eigenen Projekten einsetzt und dabei Unterstützung braucht, findet unser Angebot unter KI-Entwicklung und Agenten.
Häufige Fragen
Zum Nachschlagen die Fragen, die Leser am häufigsten stellen.
Was ist Agentic Goal Engineering?
Agentic Goal Engineering ist ein Vorbereitungsschritt für Coding-Agenten: Eine KI befragt den Auftraggeber, bis klar ist, woran sich Erfolg erkennen lässt. Heraus kommt ein schriftlicher, freigegebener Vertrag mit prüfbaren Kriterien und ohne Technikvorgaben. Er soll verhindern, dass Agenten ein ungenau formuliertes Ziel optimieren, und dient später als Maßstab für die Prüfung.
Worin unterscheidet sich Goal Engineering von Loop Engineering?
Eine Schleife prüft nur gegen die Bedingung, die sie bekommt. Ein Agent macht ein Dashboard per Cache schnell, Lighthouse zeigt 100 Punkte, alle Tests sind grün, und die Zahlen sind trotzdem eine Stunde alt. Die Schleife lief einwandfrei, das Ziel war ein anderes. Goal Engineering prüft vorab, ob die Bedingung die Absicht des Menschen trifft.
Worin unterscheidet sich Goal Engineering von Graph Engineering?
Graph Engineering organisiert, welcher Agent welche Arbeit in welcher Reihenfolge erledigt und wie Ergebnisse übergeben werden. Goal Engineering entscheidet nicht über Agenten, Reihenfolgen oder Arbeitskopien. Es liefert dem Graphen den Maßstab, auf den sich jede Aufgabe über ihre AC-ID bezieht.
Reicht nicht der Befehl /goal in Claude Code?
Der Befehl /goal lässt Claude weiterarbeiten, bis ein Prüfmodell die gesetzte Bedingung für erfüllt hält. Er prüft, ob die Bedingung gilt, nicht, ob sie richtig ist. Laut Dokumentation führt der Prüfer zudem keine Befehle aus und liest keine Dateien. Goal Engineering liefert die geprüfte Bedingung und den Maßstab für eine unabhängige Nachweisprüfung.
Ist das nicht dasselbe wie Spec-Driven Development?
Nein. Goal Engineering ist der Schritt davor, und beide lassen sich kombinieren: erst das Ziel klären, dann die Spezifikation schreiben. Die Spezifikation beschreibt Funktionen, der Goal Contract den Zustand, den diese Funktionen herstellen sollen. Goal Engineering liefert davor den freigegebenen Zielzustand samt Akzeptanzkriterien und gibt Spezifikation, Plan und Aufgaben einen prüfbaren Maßstab.
Wie viele Rückfragen stellt die KI?
Höchstens ein bis drei je Runde und nur so viele, bis alle entscheidungsrelevanten Unklarheiten geklärt sind. Ist das Ziel von Anfang an klar, entfallen die Fragen ganz. So ist es vorgesehen, im Pilot stellte der Skill bei klaren Zielen aber noch im Mittel 5,0 Fragen (Abschnitt 9), und das Modell ohne Methode fragte im Mittel 6,1-mal und traf am besten. Jede mögliche Frage wird vorher danach bewertet, wie stark ihre Antwort das Ziel verändert und wie teuer eine falsche Annahme wäre.
Wer gibt den Goal Contract frei, und was bedeutet die Freigabe?
Freigeben darf nur der berechtigte Mensch, und zwar eine konkrete, angezeigte Version. Ein bloßes „passt schon“ vor der Anzeige des Vertrags zählt nicht. Die Freigabe autorisiert die Zieldefinition, nicht die Umsetzung, keine Ausgaben und kein Deployment. Spätere Änderungen erzeugen eine neue Version, die erneut freigegeben werden muss.
Ist belegt, dass die Methodik bessere Ergebnisse liefert?
Nein. Im ersten Vergleich am 28. Oktober 2026 mit 40 Szenarien, 120 Dialogen, simuliertem Auftraggeber und zwei Modell-Gutachtern traf die Goal Engine 78 % der entscheidenden Punkte, Spec Kit 73 % und dasselbe Modell ohne Methode 89 %. Der Vorsprung gegen Spec Kit ist statistisch nicht belegt. Die Goal Engine nahm fast nie etwas Falsches an, ließ aber mehr Punkte weg.
Quellen
- Anthropic (2025): Claude 3.7 Sonnet System Card, Abschnitt 6 „Excessive Focus on Passing Tests“.
- Anthropic (o. J.): Claude Code Dokumentation: /goal. Abgerufen am 28.10.2026.
- Arike, R.; Donoway, E.; Bartsch, H.; Hobbhahn, M. (2025): Technical Report: Evaluating Goal Drift in Language Model Agents. arXiv:2505.02709.
- Belcic, I.; Stryker, C. (2026): What is loop engineering? IBM Think, 17.07.2026.
- Bouchard, L.-F. (2026): Graph Engineering vs Loop Engineering: What Actually Changed, 22.07.2026.
- Bresciani, P.; Perini, A.; Giorgini, P.; Giunchiglia, F.; Mylopoulos, J. (2004): Tropos: An Agent-Oriented Software Development Methodology. Autonomous Agents and Multi-Agent Systems 8, S. 203–236. doi:10.1023/B:AGNT.0000018806.20944.ef
- Claburn, T. (2026): Bericht zu Loop Engineering. The Register, 24.06.2026.
- Dardenne, A.; van Lamsweerde, A.; Fickas, S. (1993): Goal-directed requirements acquisition. Science of Computer Programming 20(1–2), S. 3–50. doi:10.1016/0167-6423(93)90021-G
- Delimarsky, D. (2025): Spec-driven development with AI: Get started with a new open source toolkit. GitHub Blog, 02.09.2025.
- Feng u. a. (2026): Graph Engineering in the Era of LLM Agents: From Individual Intelligence to System Intelligence. arXiv:2608.21156.
- GitHub (o. J.): Spec Kit, Befehlsvorlage
clarify. Abgerufen am 28.10.2026. - Goodhart, C. A. E. (1975): Problems of Monetary Management: The U.K. Experience. Papers in Monetary Economics, Vol. I, Reserve Bank of Australia.
- Greyling, C. (o. J.): goal-engineering. GitHub-Repository. Abgerufen am 28.10.2026.
- Horkoff, J. u. a. (2019): Goal-oriented requirements engineering: an extended systematic mapping study. Requirements Engineering 24(2), S. 133–160. doi:10.1007/s00766-017-0280-z
- Horkoff, J. u. a. (2026): A systematic mapping of goal-oriented requirements engineering: reflections, impact, and the way forward. Requirements Engineering 31, Art. 20. doi:10.1007/s00766-026-00476-7
- ISO/IEC/IEEE 29148:2018: Systems and software engineering – Life cycle processes – Requirements engineering, Abschnitt 5.2.5.
- Krakovna, V. u. a. (2020): Specification gaming: the flip side of AI ingenuity. Google DeepMind, 21.04.2020.
- Lulla, Nersesyan, Mohsenimofidi, Treude, Baltes (2026): Loop Engineering: Building Blocks, Adoption, and Impact. arXiv:2608.21884.
- Mu, F. u. a. (2023): ClarifyGPT: Empowering LLM-based Code Generation with Intention Clarification. arXiv:2310.10996.
- NASA (o. J.): Independent Verification and Validation: Overview. Abgerufen am 28.10.2026.
- North, D. (2006): Introducing BDD. Better Software, März 2006.
- OpenAI (o. J.): Using goals in Codex. OpenAI Cookbook. Abgerufen am 28.10.2026.
- Panickssery, A.; Bowman, S. R.; Feng, S. (2024): LLM Evaluators Recognize and Favor Their Own Generations. arXiv:2404.13076.
- Shen, L. u. a. (2026): Learning to Steer LLM Agents and Multi-Agent Systems. arXiv:2610.22316.
- Strathern, M. (1997): „Improving ratings“: audit in the British University system. European Review 5(3), S. 305–321.
- van Lamsweerde, A. (2001): Goal-Oriented Requirements Engineering: A Guided Tour. Proceedings RE'01, S. 249–262. doi:10.1109/ISRE.2001.948567
- von Arx, S.; Chan, L.; Barnes, B. (2025): Recent Frontier Models Are Reward Hacking. METR, 05.06.2025.
- Wang, J.; Qian, H.; Hu, Y.; Zhang, J.; Liu, Z. (2026): AgentSWE: Can Coding Agents Build the Agent You Actually Want? arXiv:2610.13361.
- Willison, S. (2026): Agentic Engineering Patterns, 23.02.2026.
- Wu, J. J.; Fard, F. H. (2025): HumanEvalComm: Benchmarking the Communication Competence of Code Generation for LLMs and LLM Agent. ACM TOSEM. doi:10.1145/3715109
- xAI (o. J.): Grok Build: Modes and Commands. Abgerufen am 28.10.2026.
- Yu, E. S. K. (1997): Towards modelling and reasoning support for early-phase requirements engineering. Proceedings ISRE '97, S. 226–235. doi:10.1109/ISRE.1997.566873
- Zheng, L. u. a. (2023): Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena. NeurIPS 2023 Datasets and Benchmarks. arXiv:2306.05685.
Hinweis: Dieser Beitrag beschreibt eine Methodik in Entwicklung, ihren Prüfplan und die Ergebnisse eines ersten Piloten mit simuliertem Auftraggeber. Er enthält kein Leistungsversprechen für einzelne Werkzeuge. Alle Angaben zu Produkten Dritter geben deren öffentliche Dokumentation zum Stand 28.10.2026 wieder.
Beitrag teilen
Bleiben Sie auf dem Laufenden
Erhalten Sie die neuesten Artikel, Insights und Branchen-Updates direkt in Ihr Postfach.
So bestimmen Sie selbst, was Google Ihnen zeigt
Google lässt Sie festlegen, welche Quellen in Ihren Suchergebnissen bevorzugt erscheinen: in den Schlagzeilen und in den KI-Antworten. Zwei Klicks, und Sie sehen die Seiten, denen Sie vertrauen.
provimedia.de zu meinen Quellen hinzufügenÄhnliche Beiträge
Weitere Artikel, die Sie interessieren könnten.
Zu Gast bei Chefgeflüster: Wie viel KI tut uns gut?
Ich war zu Gast bei Lars und Silvio im Podcast Chefgeflüster. In Folge #42 geht es um die Frage, wie viel KI einem Betrieb guttut und wo der Mensch bleiben muss.
KI im Betrieb: 7 Regeln, damit der Chef das Steuer behält (zu Chefgeflüster #42)
Ein Mitarbeiter kopiert ein Angebot ins Gratis-ChatGPT: Sieben Regeln mit konkreten Handgriffen zeigen Inhabern kleiner Betriebe, wie sie KI nutzen und die Kontrolle behalten. Anlass: Chefgeflüster #42.
Prompt Engineering lernen: Definition, Bausteine und Praxisbeispiele
Prompt Engineering klingt nach Zauberformel, ist aber erlernbares Handwerk. Dieser Leitfaden zeigt die sechs Bausteine eines guten Prompts – mit echten Vorher-Nachher-Beispielen aus dem Arbeitsalltag.
Sie setzen diese Modelle im Team ein?
Bauen Sie die KI-Kompetenz im Team gezielt auf und dokumentieren Sie sie mit einem Teilnahmezertifikat — im Rahmen von Artikel 4 EU AI Act.