Agentic Goal Engineering: primero el objetivo correcto, después el agente
Respuesta breve: Agentic Goal Engineering aclara, antes de que un agente de IA empiece a trabajar, qué resultado cuenta como éxito. La IA pregunta por el resultado deseado, formula preguntas concretas y deduce criterios de aceptación verificables. Ambas cosas constan en un Goal Contract (un contrato escrito del objetivo) aprobado por una persona. Solo después los agentes planifican, construyen y verifican contra ese contrato. Un primer piloto del 28 de octubre de 2026 aún no demuestra ninguna ventaja frente a Spec Kit ni frente a un modelo sin método.
Fecha: 28 de octubre de 2026 · Autor: Alexander Weipprecht, Provimedia GmbH · Tiempo de lectura: unos 35 minutos
De qué se trata
Un agente debe hacer más rápido un panel de control. Al final hay un Lighthouse 100 (la nota máxima en la medición de rendimiento de Google) y todas las pruebas en verde, y las cifras del panel tienen una hora de antigüedad. Lo que se quería era rápido y actualizado. Lo que se dijo fue solo «más rápido».
Ninguna prueba salta. Los agentes de programación trabajan hoy de forma autónoma durante horas y se mejoran en bucles hasta que se cumple una condición de parada. Los especialistas llaman Loop Engineering al diseño de esos bucles y Graph Engineering a la conexión de muchos bucles y agentes. Pero un bucle solo comprueba contra la condición que ha recibido. Ninguna de las dos disciplinas detecta si esa condición corresponde a lo que la persona quería.
Aquí se sitúa este artículo. Tras leerlo, usted podrá revisar una condición /goal (la condición de parada en Claude Code) en busca de errores de objetivo, separar las propuestas de un agente de sus propias exigencias y escribir criterios de aceptación que un agente tenga más difícil reinterpretar.
La situación real: Provimedia está desarrollando actualmente el procedimiento como skill /goalengine para Claude Code y Code Guardian. Existe una primera comparación con 120 diálogos, y el resultado es desfavorable: frente a Spec Kit (la herramienta de GitHub para el desarrollo guiado por especificaciones) no se ha demostrado ventaja alguna, y el mismo modelo sin método fue el que mejor acertó con la intención. La sección 9 muestra todas las cifras. Este artículo describe, por tanto, un método fundamentado cuya utilidad todavía no está demostrada.
Qué hacer mañana
Cinco pasos que puede aplicar de inmediato, sin skill y sin conocimientos previos. Están ordenados según las pruebas disponibles: primero lo que midió el piloto, después lo que solo está fundamentado. Cuando aparece un término técnico, va entre paréntesis; las secciones posteriores lo explican.
- Deje que el agente pregunte primero. Permita preguntas y límitelas a unas ocho, por ejemplo con: «Antes de empezar: hazme hasta ocho preguntas sobre cómo mediría yo el resultado». Para ello no necesita una plantilla de método ya preparada. Medido: este brazo (el mismo modelo, sin método) acertó mejor en el piloto, con un 89,4 % de los puntos correctos. No hubo ningún brazo sin preguntas.
- Anote detrás de cada requisito de quién procede. O lo dijo usted, o lo propuso el agente. Ejemplo: «Tiempo de respuesta de 5 segundos como máximo (propuesta de la IA, aún sin confirmar)». Solo cuando usted lo confirma pasa a ser una exigencia. En el procedimiento, esta etiqueta se llama
AI_PROPOSED. Medido en el procedimiento B, que usa esas etiquetas: un 0,2 % de puntos asumidos erróneamente, frente al 4,4 % y el 6,8 %. La contribución de la etiqueta por sí sola no está aislada. - Mantenga visibles los puntos abiertos. Lo que nadie ha confirmado no se borra, sino que se anota como abierto. Ejemplo: «Abierto: ¿qué antigüedad máxima pueden tener las cifras? Aún sin aclarar». Lección del piloto.
- En la condición
/goal, describa el estado, no la solución. No: «Integra caché con Redis». Sino: «El panel carga en 1,5 segundos como máximo y muestra cifras de 60 segundos de antigüedad como máximo». Así el agente puede encontrar por sí mismo el mejor camino. Ayuda formular una pregunta de control (sección 6): ¿la respuesta cambia lo que cuenta como éxito? Fundamentado, no medido. - Redacte los criterios de éxito de modo que alguien pueda comprobarlos. Ejemplo: «Dado: el panel con datos de prueba. Cuando: lo abro 20 veces seguidas. Entonces: cada apertura tarda 1,5 segundos como máximo y las cifras tienen 60 segundos de antigüedad como máximo. Cómo se verifica: script de medición, datos en bruto guardados». Este formato se llama criterio de aceptación (la sección 7 lo muestra completo). Fundamentado, no medido.
De un vistazo
¿Qué pregunta le ocupa? La tabla ofrece la respuesta breve y la sección en la que se fundamenta.
| Su pregunta | Respuesta breve | Sección |
|---|---|---|
| ¿Por qué los agentes fallan el objetivo aunque todas las pruebas estén en verde? | Cada bucle solo comprueba contra la condición que ha recibido. Si la condición no es la correcta, el agente optimiza con fiabilidad lo equivocado. | 1 |
| ¿Qué diferencia hay con Loop y Graph Engineering? | Loop itera hasta la condición, Graph reparte el trabajo, Goal Engineering aclara de antemano si es la condición correcta. | 2 y 3 |
| ¿Cómo funciona el método? | 6 pasos (GE-01 a GE-06), verificados contra 7 dimensiones del objetivo. El resultado es un contrato del objetivo aprobado. | 4 y 5 |
| ¿Qué preguntas hace la IA y cuáles no? | Solo preguntas cuya respuesta cambia lo que cuenta como éxito. 6 etiquetas de procedencia separan sus exigencias de las propuestas de la IA. | 6 y 4 |
| ¿Cómo se ve con un ejemplo? | La búsqueda con IA para un foro, desde el deseo vago hasta el criterio verificable. | 7 |
| ¿Qué impide que el agente reinterprete el objetivo? | 2 controles de calidad (antes y después de la implementación), 5 medidas de protección contra la optimización de proxies y 8 estados, ninguno de los cuales significa «alcanzado». | 8 |
| ¿Ayuda el método de forma demostrable? | Hasta ahora no: en la primera comparación con 120 diálogos no se ha demostrado ventaja alguna. Sí hay 16 casos de aceptación para el propio skill. | 9 |
| ¿Cuán nueva es la idea? | El análisis de requisitos orientado a objetivos existe desde hace más de 30 años. Lo nuevo es su aplicación a los agentes de programación. | 10 |
| ¿Qué puedo hacer ya? | Cinco pasos sin skill, véase «Qué hacer mañana» más arriba. | 7 |
1. El problema: un agente puede resolver la tarea y fallar el objetivo
Primero, la pregunta de por qué los agentes trabajan al margen del objetivo pese a las pruebas en verde. Un agente que ejecuta una tarea sin tacha no ha resuelto por ello el problema de su cliente. La brecha entre ambas cosas es antigua, pero los sistemas agénticos la agrandan. Cuanto más tiempo trabaja un agente sin preguntar, más lejos lo lleva una suposición errónea del primer prompt.
Un ejemplo lo hace tangible. Alguien escribe: «El panel debe ser más rápido». Un agente mide el tiempo de carga, introduce una caché, alcanza 100 puntos en la prueba de Lighthouse y da por logrado el éxito.
Después, el panel muestra cifras con una hora de antigüedad. El agente ha cumplido su propio criterio de verificación. El objetivo del usuario, ver rápidamente cifras actuales, lo ha fallado. Ninguna prueba estaba en rojo y ningún bucle lo notó, porque cada bucle comprueba contra el criterio que ha recibido.
Este patrón está bien documentado. Lo acreditan cuatro hallazgos:
- DeepMind lo describe como Specification Gaming: un comportamiento «que satisface la especificación literal de un objetivo sin alcanzar el resultado pretendido» (Krakovna et al. 2020).
- Anthropic señala en la System Card de Claude 3.7 Sonnet: en entornos agénticos como Claude Code, el modelo introduce ocasionalmente casos especiales para superar los casos de prueba. En casos aislados, adapta las propias pruebas a la salida del código (Anthropic 2025, sección 6).
- METR detectó en un modelo actual, en 39 de 128 ejecuciones de un benchmark de investigación, intentos de burlar la evaluación (von Arx, Chan y Barnes 2025).
- Un estudio de octubre de 2026 examinó si los agentes de programación pueden construir el agente que un requisito realmente exige. Ninguno de los agentes probados se acerca a ello. Son típicos el sobreajuste a casos de prueba visibles, tiempos de ejecución vacíos tras un código de apariencia terminada y avisos de finalización sin respaldo (Wang et al. 2026).
Detrás hay una ley más antigua que cualquier IA. El economista Charles Goodhart formuló en 1975 que toda regularidad estadística observada se desmorona en cuanto se utiliza para dirigir. Marilyn Strathern la resumió en 1997 en la forma que hoy se cita: «Cuando una medida se convierte en objetivo, deja de ser una buena medida» (Strathern 1997).
Para los agentes esto significa: un agente optimiza lo que se ha hecho medible. Si se ha hecho medible lo equivocado, optimiza con fiabilidad lo equivocado.
A ello se suma una segunda fuente de error, más silenciosa: los objetivos se desplazan durante el trabajo. Dos trabajos lo demuestran:
- Arike y colaboradores definen Goal Drift (deriva del objetivo) como la tendencia de un agente a alejarse con el tiempo de su objetivo original. La detectan, en distinta medida, en todos los modelos probados (Arike et al. 2025).
- Un trabajo del 15 de octubre de 2026 describe lo mismo para sistemas multiagente que, en el curso de la ejecución, se desvían del objetivo global (Shen et al. 2026).
De ambos hallazgos se deriva la pregunta de partida de este artículo: ¿quién garantiza que el objetivo es correcto antes de que los agentes empiecen, y que sigue siendo el mismo durante el trabajo?
2. Términos: qué significan hoy Loop, Graph y Goal Engineering
La pregunta con la que termina la primera sección presupone que está claro quién es responsable de qué. Los términos de este campo son jóvenes y no están normalizados. Esta sección fija en qué sentido los usa el artículo y los respalda con fuentes. Cómo se relaciona Goal Engineering con la investigación lo sitúa la sección 10.
Agentic Engineering
Agentic Engineering es el desarrollo de software con agentes de programación que no solo escriben código, sino que lo ejecutan, lo prueban y lo desarrollan. Simon Willison lo describe así: los agentes trabajan con independencia de la guía paso a paso de su supervisor humano (Willison 2026). Es el concepto general de las tres disciplinas siguientes.
Loop Engineering
Loop Engineering es la práctica de diseñar flujos de trabajo agénticos o bucles que guían a agentes de IA de forma iterativa hacia objetivos definidos por el usuario con la menor intervención humana posible (Belcic y Stryker 2026). Así lo define IBM.
Un estudio sobre sus componentes y su difusión resume el cambio: los desarrolladores construyen sistemas que dan prompts al agente por ellos, en lugar de dar prompts ellos mismos (Lulla et al. 2026). Como detonante del debate se considera una publicación del desarrollador Peter Steinberger del 7 de junio de 2026: ya no habría que dar prompts a los agentes de programación, sino diseñar bucles que se ocupen de ello (Claburn 2026). No está documentado quién acuñó el término.
Es importante un detalle de la definición: Loop Engineering trabaja hacia objetivos definidos por el usuario. De dónde viene ese objetivo y si es correcto queda fuera de su ámbito de responsabilidad.
Graph Engineering
Un survey con 35 autores describe Graph Engineering así: la construcción de estructuras de grafo explícitas, dinámicas y en evolución que representan tareas, agentes y estados del sistema (Feng et al. 2026). Los nodos son agentes, herramientas, código determinista, pruebas o revisiones humanas. Las aristas son traspasos y dependencias.
Los profesionales lo describen como la conexión de varios bucles de agentes en un sistema orquestado (Bouchard 2026). El término no está normalizado y circula al menos con tres significados: como grafo de ejecución, como grafo de bucles y controles y como grafo de conocimiento. Este artículo usa el primero: Graph Engineering organiza quién hace qué y en qué orden.
Goal Engineering: el término ya está ocupado, pero con otro sentido
El término «Goal Engineering» ya existe. Goal Engineering en el sentido de Cobus Greyling es la sustitución de prompts puntuales por objetivos verificables en los que un agente trabaja hasta que se cumplen. Greyling refiere el término al comando /goal de la CLI de Grok Build (Greyling s. f.). Hoy todos los grandes agentes de programación tienen comandos comparables:
- Claude Code: tras cada ronda, un modelo comprueba si se cumple la condición establecida; si no se cumple, Claude inicia la siguiente ronda. Técnicamente,
/goales un stop hook basado en prompt y ligado a la sesión. El verificador no ejecuta ningún comando por sí mismo ni lee archivos. Juzga lo que consta en el historial de la conversación (Anthropic s. f.). - OpenAI Codex: un objetivo queda ligado de forma permanente a un hilo, puede pausarse y reanudarse, y solo se considera cumplido tras contrastarlo con evidencia concreta. Haber agotado un presupuesto no cuenta expresamente como finalización (OpenAI s. f.).
- Grok Build: varios subagentes verificadores evalúan el resultado. El objetivo solo se alcanza cuando la mayoría lo aprueba (xAI s. f.).
Los tres comandos responden a la misma pregunta: ¿Se cumple la condición? Ninguno responde a la pregunta previa: ¿Es la condición correcta? El texto de una condición /goal procede de la persona, y su calidad decide cuándo se detiene el agente. Una condición vaga produce una parada en el momento equivocado; una condición incorrecta, una parada con el resultado equivocado.
Agentic Goal Engineering, en el sentido de este artículo, actúa precisamente ahí. No resuelve ningún objetivo, sino que lo determina, lo afina, lo verifica y lo conserva. Entrega la condición que un comando /goal comprobará más adelante y la vara de medir con la que debe poder medirse cada verificación posterior.
Definición de trabajo. Agentic Goal Engineering es una metodología asistida por IA con la que una IA determina, afina, verifica y mantiene a lo largo de toda la implementación los objetivos humanos. Su resultado es un Goal Contract neutral respecto a la solución, trazable y verificable, que sirve como base vinculante para el logro autónomo del objetivo por parte de agentes de IA.
Los términos de un vistazo
La tabla sitúa los cinco términos uno junto a otro. Cada uno responde a una pregunta central distinta.
| Término | Pregunta central | Fuente |
|---|---|---|
| Agentic Engineering | ¿Cómo se desarrolla con agentes de programación? | Willison 2026 |
| Loop Engineering | ¿Cómo itera el agente hasta la condición? | Belcic y Stryker 2026 |
| Graph Engineering | ¿Quién hace qué y en qué orden? | Feng et al. 2026 |
| Goal Engineering (Greyling) | ¿Se cumple la condición? | Greyling s. f. |
| Agentic Goal Engineering | ¿Es la condición correcta? | este artículo |
3. Delimitación: quién responde a qué pregunta
Con los términos en mente, surge la pregunta de qué tarea asume cada uno. Goal, Graph y Loop Engineering no son competidores, sino distintos niveles de responsabilidad. Cada uno responde a una pregunta distinta y genera un artefacto distinto. Si se confunden, un nivel responde a la pregunta de otro, y de ahí nacen precisamente los errores de la sección 1.
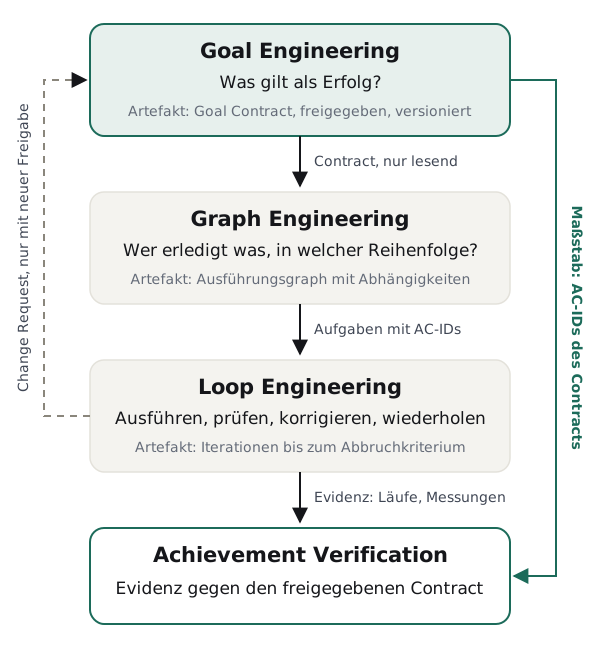
| Nivel | Pregunta central | Artefacto | No debe |
|---|---|---|---|
| Goal Engineering | ¿Qué cuenta como éxito, para quién y con qué límites? | Goal Contract | Fijar la tecnología o el camino de solución |
| Hito | ¿Qué estado intermedio verificable conduce al objetivo? | Hito con criterios | Inventar valores objetivo |
| Tarea | ¿Qué trabajo concreto hay que hacer? | Task | Reinterpretar un criterio |
| Graph Engineering | ¿Quién hace qué y en qué orden? | Grafo de ejecución | Sustituir el deseo del usuario |
| Loop Engineering | ¿Cómo se acerca el trabajo iterativamente al criterio? | Bucle de iteración | Desplazar el valor objetivo durante el bucle |
| Verificación | ¿La evidencia demuestra el criterio? | Informe de verificación | Desactivar un criterio en silencio |
Dos frases resumen la delimitación. Un bucle puede funcionar sin fallos y alcanzar el objetivo equivocado. Un grafo puede estar impecablemente organizado y entregar un resultado que nadie quería. Ambos presuponen que el objetivo es suficientemente claro. Agentic Goal Engineering establece esa condición previa.
De ahí resulta una regla de responsabilidad sencilla: Goal Engineering decide sobre el qué, el porqué y el éxito. Los sistemas posteriores deciden sobre el cómo, el cuándo y el quién. La implementación puede comunicar problemas de viabilidad. Lo que no puede es debilitar el Goal Contract.
La representación es conceptual, no una arquitectura necesariamente lineal. Los grafos pueden contener bucles, y las verificaciones tienen lugar durante y después de la ejecución. Lo decisivo es la dirección de la dependencia: cada nivel inferior se refiere al superior, nunca al revés.
4. La metodología: seis pasos desde el deseo vago hasta el contrato aprobado
Una vez delimitado el nivel del objetivo, queda la pregunta de cómo proceder en él. Agentic Goal Engineering se desarrolla en seis pasos, GE-01 a GE-06. El procedimiento está recortado a propósito: no planifica, no construye y no descompone el objetivo en tareas. Su único resultado es un Goal Contract aprobado.
Qué parte de estos componentes respalda el piloto (cifras en la sección 9):
- Respaldado: las etiquetas de procedencia. El procedimiento B asumió erróneamente el 0,2 % de los puntos y escribió 2,7 requisitos sin fundamento por documento; los demás brazos, del 4,4 al 6,8 % y 16,0 a 17,1.
- Refutado en su forma actual: eliminar los puntos sin confirmar y el mínimo de preguntas. B omitió el 21 % de los puntos e hizo 5,0 preguntas con objetivos claros. El mejor brazo fue, al mismo tiempo, el que más preguntó.
- No medido: modelo de estados, contrato congelado, verificación separada, detección de deriva y el efecto sobre la implementación posterior.
Esta estrechez es la decisión de diseño más importante. En cuanto la misma instancia que aclara el objetivo reflexiona también sobre la solución, la solución empieza a moldear el objetivo.
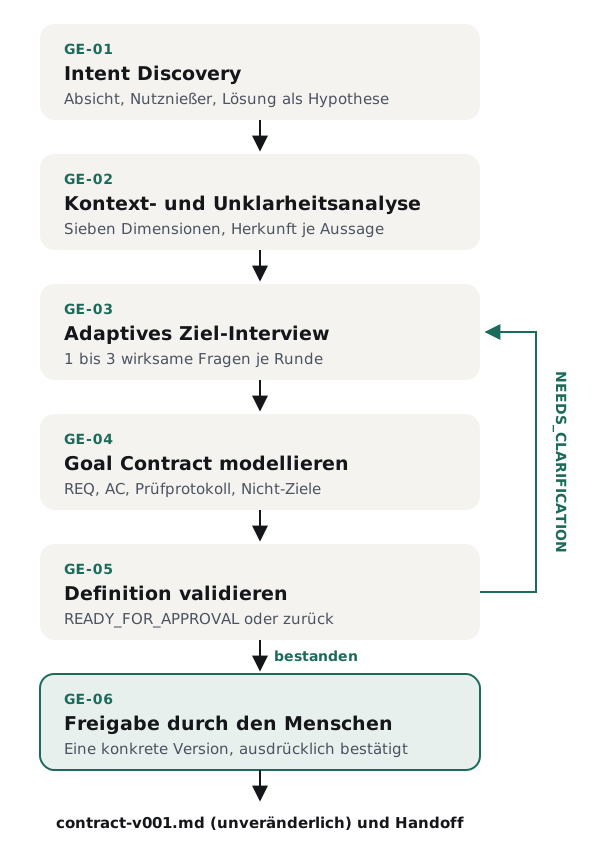
GE-01: Intent Discovery. ¿Qué debe ser distinto, y para quién?
El primer paso pregunta por el estado deseado, por los afectados y por el problema real. Con ello separa cuatro cosas que en una formulación humana casi siempre están mezcladas: el resultado, la solución propuesta, el contexto y la suposición.
Un usuario que escribe «Integra Redis» formula una solución. Detrás puede haber «reducir los tiempos de respuesta» o, igualmente, «reducir los costes de base de datos». Ambos objetivos exigen criterios de éxito distintos y quizá soluciones distintas.
Por eso Agentic Goal Engineering anota Redis, de entrada, como hipótesis. Solo se convierte en exigencia vinculante si el usuario lo establece expresamente como condición de contorno, por ejemplo porque la infraestructura ya está preparada para ello.
GE-02: Análisis de contexto y de incertidumbres
En el segundo paso, la IA contrasta lo conocido hasta ahora con siete dimensiones del objetivo (sección 5) y lee la documentación existente del proyecto, en la medida en que influya en el significado del objetivo. Una implementación existente aporta una situación de partida, no un objetivo: que hoy una página tarde cuatro segundos en cargar no dice nada sobre lo rápido que debería cargar.
Cada afirmación recibe una etiqueta de procedencia. Es la herramienta más importante contra un problema que se pasa por alto con facilidad en el trabajo de requisitos asistido por IA: propuestas de la IA que, sin que nadie lo note, parecen requisitos del usuario.
| Etiqueta | Significado | ¿Puede volverse vinculante? |
|---|---|---|
USER_EXPLICIT | El usuario lo dijo él mismo | Sí |
USER_CONFIRMED | La IA lo propuso, el usuario lo confirmó | Sí |
PROJECT_EVIDENCE | Acreditado por código, documentación o medición del proyecto | Como situación de partida o límite, no como valor objetivo |
EXTERNAL_REQUIREMENT | Ley, norma, contrato o requisito de seguridad con fuente | Sí, con indicación de la fuente |
AI_PROPOSED | Propuesta de la IA, aún sin confirmar | No, nunca |
UNKNOWN | Abierto, pendiente de aclarar o medir | No |
En el piloto: 2,7 requisitos vinculantes sin fundamento por documento, frente a 16,0 a 17,1 (sección 9).
GE-03: Entrevista adaptativa sobre el objetivo
Solo ahora la IA hace preguntas, y como máximo de una a tres por ronda. Qué preguntas son lo decide no un catálogo fijo, sino el modelo de incertidumbre de GE-02. Si el objetivo ya está claro, las preguntas deben omitirse por completo. En el piloto: 5,0 preguntas incluso con objetivos claros, algo aún no logrado (sección 9). La lógica de las preguntas se describe en detalle en la sección 6.
GE-04: Modelar el Goal Contract
De la intención y las respuestas surge un borrador de contrato. Contiene solo enunciados referidos al resultado y los enlaza en una cadena fija: procedencia de la intención, decisión, requisito (REQ), criterio de aceptación (AC) y protocolo de verificación. La sección 7 muestra esta cadena en un ejemplo completo.
GE-05: Validar la definición
Este paso verifica la definición, no el software. Pregunta si el borrador refleja fielmente la intención, si es completo, libre de contradicciones y verificable, y si no contiene prescripciones de solución sin fundamento. Si falta una aclaración decisiva para el éxito, el resultado es NEEDS_CLARIFICATION y el flujo vuelve a la entrevista. La sección 8 describe los criterios de verificación.
GE-06: Aprobación y entrega
El usuario ve un resumen conciso y completo: objetivo, círculo de usuarios, criterios obligatorios, no objetivos, límites, métodos de verificación y puntos abiertos. Aprueba una versión concreta. Solo después se crea un archivo inmutable, por ejemplo contract-v001.md. Un «vale, está bien» antes de haber mostrado siquiera el contrato no es una aprobación.
Es igualmente importante lo que la aprobación no significa. Quien aprueba un contrato de objetivo no aprueba con ello ni la implementación, ni gastos, ni un despliegue. La entrega a la planificación y a la ejecución es un paso propio y expreso.
5. Las siete dimensiones de una definición completa del objetivo
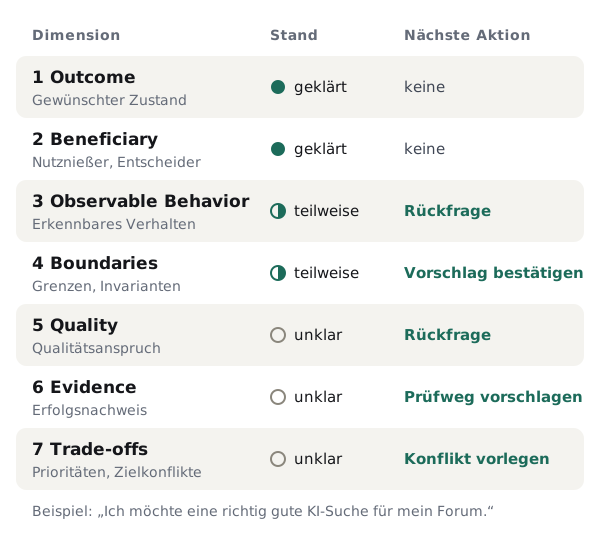
La entrevista (GE-03) necesita una vara de medir para saber cuándo un objetivo está completo. Para que la IA reconozca dónde un objetivo sigue siendo poco claro, necesita un modelo de en qué consiste una definición completa del objetivo. Agentic Goal Engineering utiliza siete dimensiones. No son un formulario que rellena el usuario, sino una comprobación interna de integridad.
La IA anota primero todo lo que ya sabe por la descripción y por el proyecto. Solo pregunta donde queda una laguna decisiva.
| Dimensión | Pregunta guía |
|---|---|
| 1. Outcome | ¿Qué debe cambiar concretamente gracias al resultado? ¿Qué problema queda entonces resuelto? |
| 2. Beneficiary | ¿Para quién surge el beneficio? ¿Quién puede determinar qué es el éxito? |
| 3. Observable Behavior | ¿Qué debe ser visible, perceptible o medible de otra manera una vez alcanzado el objetivo? |
| 4. Boundaries | ¿Qué no debe modificarse, empeorarse ni vulnerarse? |
| 5. Quality | ¿Qué calidad debe tener el resultado? ¿Qué conflictos de objetivos son relevantes? |
| 6. Evidence | ¿Qué observación, medición o aceptación puede demostrar el logro del objetivo? |
| 7. Trade-offs | ¿Qué propiedades son obligatorias y cuáles negociables cuando no se puede tener todo a la vez? |
Las dimensiones recogen categorías conocidas del análisis de requisitos orientado a objetivos. Los objetivos y su refinamiento están en Outcome y Observable Behavior; los interesados y sus intenciones, en Beneficiary (como en i*). Los obstáculos y las invariantes están en Boundaries (como en KAOS), y los conflictos de objetivos, en Trade-offs.
Lo nuevo es la dimensión Evidence como obligación independiente: un objetivo para el que no cabe imaginar ninguna prueba no puede ser declarado alcanzado después por nadie, tampoco por un agente.
Durante la entrevista, la IA mantiene un estado para cada dimensión. La figura 3 muestra este modelo de incertidumbre con un ejemplo que la sección 7 desarrolla más adelante.
6. La lógica de las preguntas: cómo del resultado surgen las preguntas correctas
Conocidas las lagunas, queda la cuestión de qué pregunta la IA a continuación. El núcleo de la metodología es la pregunta de qué pregunta se formula. Aquí se decide si Agentic Goal Engineering afina el objetivo del usuario o lo sustituye sin que se note por la solución de la IA.
El criterio de delimitación para cada pregunta
Una única regla separa las preguntas sobre el objetivo de todas las demás:
Una pregunta pertenece a la aclaración del objetivo si su respuesta modifica qué resultado cuenta como exitoso, y no solo cómo se alcanza técnicamente ese resultado.
| Pregunta | Pertenece a | Justificación |
|---|---|---|
| ¿Qué debe poder conseguir un visitante al final? | Goal Engineering | Define el éxito |
| ¿Debe cada respuesta citar fuentes? | Goal Engineering | Define una calidad del resultado |
| ¿Qué se considera una afirmación falsa inaceptable? | Goal Engineering | Define un límite de calidad |
| ¿PostgreSQL o MariaDB? | Planificación | Elección técnica de la solución |
| ¿Deben usarse embeddings? | Planificación | Estrategia de implementación |
| ¿Qué agente programa la interfaz? | Graph Engineering | Organización del trabajo |
| ¿Cuántas veces se reintenta tras una prueba en rojo? | Loop Engineering | Control de la ejecución |
Una excepción es importante: los límites expresos del usuario pertenecen al contrato, aunque suenen técnicos. «No se debe modificar la infraestructura existente» o «Nos quedamos con Qdrant porque el resto de la empresa lo utiliza» son condiciones de contorno válidas. Constan en el contrato como Constraint, no como objetivo, y nunca sustituyen la descripción del resultado deseado.
Preguntas de descubrimiento antes que preguntas de precisión
Agentic Goal Engineering distingue dos tipos de preguntas y las formula en un orden fijo.
Las preguntas de descubrimiento ayudan al usuario a reconocer su verdadero objetivo. Son abiertas y neutrales respecto a la solución. Ejemplos: ¿Qué quiere conseguir al final? ¿Por qué es importante para usted? ¿Qué no funciona hoy? ¿Qué sería distinto si el problema estuviera completamente resuelto? ¿Qué le decepcionaría aunque el software funcione técnicamente?
Las preguntas de precisión llegan solo cuando se ha entendido la intención. Hacen medible una cualidad del objetivo ya reconocida: ¿Qué significa «rápido» para usted, serían aceptables cinco segundos? ¿Debe el sistema decir abiertamente cuando una respuesta no está suficientemente respaldada?
El orden tiene una razón. Los modelos de lenguaje tienden a proponer soluciones ya durante la aclaración de requisitos. Tras cinco preguntas de carácter técnico, un usuario que originalmente quería A describe de pronto B como su objetivo, porque las preguntas le han sugerido B.
La metodología lo llama Solution Bias (sesgo de solución). Comprueba cada pregunta prevista para ver si presupone una solución determinada o amplía el alcance del objetivo sin encargo del usuario. El principio: La IA puede ayudar a expresar con más precisión la voluntad del usuario. No puede sustituirla por su solución preferida.
En el piloto: un 0,6 % de preguntas que se adelantan a la solución, frente a cerca del 10 % (sección 9).
Adaptive Goal Elicitation (obtención adaptativa del objetivo): preguntar con eficacia en lugar de mucho
Una entrevista que pregunta por cada incógnita cansa al usuario y diluye las preguntas importantes entre las irrelevantes. Por eso la IA evalúa de antemano cada posible pregunta según cinco criterios:
- Efecto: ¿cuánto podría modificar la respuesta la interpretación del objetivo?
- Coste del error: ¿cuán cara sería una suposición equivocada en este punto?
- Averiguabilidad: ¿puede obtenerse la información de fuentes fiables del proyecto en lugar de preguntar al usuario?
- Responsabilidad: ¿es una decisión de valores o de preferencias que solo puede tomar la persona, o puede la IA hacer una propuesta poco crítica?
- Ganancia de información: ¿qué pregunta aclara la mayor parte de la incertidumbre aún relevante?
De ahí resulta un principio de parada que la metodología llama Minimum Necessary Clarification (aclaración en el mínimo necesario). La IA pregunta hasta que todas las incertidumbres relevantes para la decisión están aclaradas, y no más.
Un caso límite que falte puede documentarse como punto abierto y tratarse más tarde. Un requisito central sin aclarar nunca debe asumirse en silencio. Si el usuario aporta desde el principio una definición del objetivo completa y clara, la entrevista se omite por completo. Un catálogo rígido de veinte preguntas obligatorias sería entonces un error, no una virtud. Así está previsto; en el piloto, sin embargo, con objetivos claros el skill aún hacía de media 5,0 preguntas (sección 9).
Cinco tipos de preguntas
| Tipo | Ejemplo |
|---|---|
| Descubrimiento | «¿Qué debe ser distinto después, y para quién?» |
| Precisión | «¿Qué significa fiable para usted y qué se puede permitir que falle?» |
| Límites | «¿Qué capacidades actuales deben conservarse?» |
| Priorización | «Si la velocidad y la actualidad chocan, ¿cuál tiene prioridad?» |
| Prueba | «¿Qué tendría que observar alguien para que usted dé por demostrado el logro del objetivo?» |
En cambio, no pertenecen a la entrevista sobre el objetivo las preguntas sobre base de datos, framework, número de copias de trabajo paralelas o reparto de módulos entre agentes. Son legítimas, pero solo en la planificación.
7. Un ejemplo resuelto paso a paso: la búsqueda con IA para un foro
Hasta aquí era teoría. Ahora el camino completo se recorre con un ejemplo. Un usuario escribe: «Quiero una búsqueda con IA realmente buena para mi foro». El patrón es el mismo que con el panel: de un deseo vago surge enseguida la solución equivocada. Con esta frase se puede mostrar todo el camino desde el deseo hasta el criterio verificable.
Qué preguntaría un agente corriente
Un agente de programación sin aclaración del objetivo empieza normalmente por lo técnico: ¿Qué base de datos vectorial? ¿OpenAI o Claude? ¿Deben guardarse los embeddings en caché? ¿Qué interfaz debe ofrecer la búsqueda? Cada una de estas preguntas tiene sentido para la implementación.
Juntas, sin embargo, presuponen en silencio que la solución es una búsqueda semántica con base de datos vectorial. Quizá el usuario ni siquiera quiere una lista de resultados, sino una respuesta fundamentada, en segundos, extraída de millones de discusiones antiguas. Eso sería otro problema con otros criterios de éxito.
Qué pregunta Agentic Goal Engineering
En la primera ronda, la Goal Engine formula preguntas de descubrimiento, ninguna de las cuales presupone una técnica:
- ¿Qué debe poder hacer mejor un visitante después de usarla, en comparación con hoy?
- ¿Debe la búsqueda ofrecer una lista de discusiones pertinentes o formular directamente una respuesta?
- ¿Qué importancia tiene para usted que cada afirmación se remita a mensajes concretos del foro?
En la segunda ronda siguen, según la respuesta, preguntas de límites y de precisión: ¿Qué no debe ocurrir bajo ningún concepto, aunque la búsqueda se vuelva más lenta por ello? ¿Qué significa «rápido» para usted? ¿Cómo reconocería usted, tras el lanzamiento, con visitantes reales, que la mejora ha merecido la pena?
La intención del objetivo, ya precisada
De las respuestas surge una intención del objetivo que todavía no es una especificación técnica:
«Los visitantes deben obtener, a partir de las discusiones existentes del foro, respuestas comprensibles a preguntas formuladas en lenguaje natural, con fuentes verificables. Si faltan pruebas suficientes, el sistema debe decirlo abiertamente en lugar de inventar una respuesta».
El Goal Contract en tres niveles
El contrato se articula en tres niveles: la intención (por qué y qué), los requisitos (criterios de éxito, límites, exclusiones, prioridades) y la evidencia (vías de verificación acordadas de antemano). Se completa con la procedencia de cada decisión vinculante y la nota de aprobación.
| Ámbito | Contenido (borrador de ejemplo GE-001, valores aún por confirmar) |
|---|---|
| Intención | Los visitantes plantean preguntas complejas y reciben respuestas comprensibles, respaldadas por mensajes del foro. |
| REQ-01 (Obligatorio) | Las respuestas son técnicamente correctas para un catálogo representativo de preguntas. |
| REQ-02 (Obligatorio) | Toda afirmación factual basada en contenidos del foro está respaldada por mensajes pertinentes. |
| REQ-03 (Obligatorio) | Las respuestas llegan sin un tiempo de espera que haga que los visitantes abandonen. |
| REQ-04 (Obligatorio) | Cuando las fuentes son insuficientes, el sistema lo indica expresamente. |
| Invariante | La búsqueda actual del foro sigue plenamente operativa. |
| No objetivos | No sustituir el foro. No dar respuestas sin respaldo para parecer más completo. No fijar un proveedor de IA. |
| Evidencia | Catálogo de preguntas fijado de antemano, revisión de respuestas y fuentes por peritos, medición de los tiempos de respuesta, pruebas de regresión de la búsqueda antigua. |
Del resultado al criterio de aceptación: la cadena de procedencia
Cada criterio de aceptación del contrato debe poder rastrearse hasta la intención literal del usuario. La figura 4 lo muestra con el tiempo de respuesta.
El formato de los criterios sigue el esquema Given-When-Then que Dan North introdujo en 2006 para el desarrollo guiado por el comportamiento: un estado inicial, un evento, un resultado observable (North 2006).
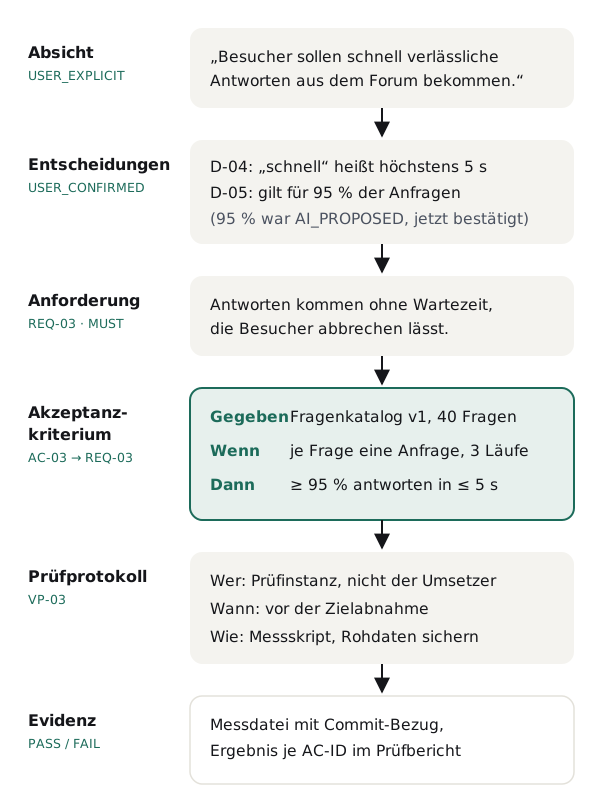
La cadena completa es: procedencia de la intención → decisión → REQ-ID → AC-ID → protocolo de verificación. Tiene tres consecuencias prácticas. Una prueba o un hito posteriores pueden remitir a un AC-ID sin reescribir su texto. Un requisito sin procedencia salta a la vista de inmediato. Y quien quiera cambiar un criterio ve qué decisión del usuario toca con ello.
Un criterio del contrato tiene por eso una forma fija:
AC-03 | Muss | Gegeben: Fragenkatalog v1 (40 Fragen)
       | Wenn: je Frage eine Anfrage über die Suche, 3 Läufe
       | Dann: mindestens 95 % der Antworten in höchstens 5 s
       | Prüfung: Messskript, Rohdaten gesichert
       | Evidenz: Messdatei mit Commit-Bezug
       | Prüfer: Prüfinstanz, nicht der Umsetzer | Status: PENDING
Propiedades de los buenos requisitos
Cada requisito del contrato debe tener seis propiedades. Se apoyan en las características de calidad de los requisitos individuales que describe la norma ISO/IEC/IEEE 29148:2018 en el apartado 5.2.5, entre ellas inequívoco, necesario, realizable y verificable.
| Propiedad | Qué garantiza |
|---|---|
| Inequívoco | No admite dos interpretaciones defendibles |
| Observable | El resultado puede constatarse |
| Verificable | Hay acordado un procedimiento de verificación adecuado |
| Trazable | El requisito procede de la intención, de una decisión confirmada o de una obligación acreditada |
| Priorizado | Los criterios obligatorios y los opcionales son distinguibles |
| Neutral respecto a la solución | Sin condicionamiento técnico innecesario |
Dónde las cifras no encajan
No todo objetivo puede traducirse honestamente a una cifra, y la metodología prohíbe expresamente la falsa precisión. Hay cuatro casos especiales regulados:
- Calidad subjetiva: «El diseño debe transmitir calidad» no se convierte en un valor de Lighthouse inventado, sino en una aceptación acordada con ejemplos representativos y responsables de decisión designados.
- Objetivos de negocio: «Un 30 por ciento más de ventas» depende de factores ajenos al software y solo se aprecia al cabo de meses. Por eso el contrato separa la aceptación del producto (lo que el software debe cumplir) de la medición del efecto (lo que cabe observar después). No promete ningún aumento de ventas.
- Objetivos exploratorios: un objetivo válido también puede ser una base de decisión sólida. La metodología no fuerza entonces la construcción de un producto.
- Varios interesados: si los deseos de distintos interesados se contradicen, la IA expone el conflicto. Sin una decisión legitimada no hay aprobación.
Igualmente vale: la claridad del objetivo no es una garantía de viabilidad. Si todos los criterios son alcanzables técnica y económicamente y dentro del presupuesto lo aclara la planificación posterior. Si esta constata que un criterio no es alcanzable, la cuestión vuelve a la persona como Change Request.
Aplicable ya hoy
También utilizables sin el skill: los pasos de «Qué hacer mañana» más arriba. El criterio de aceptación (AC) lo redacta usted en la forma de esta sección: Dado (situación de partida), Cuando (evento), Entonces (resultado esperado), verificación y evidencia (cómo y con qué se demuestra).
8. Cómo debe mejorar el enfoque la calidad
El ejemplo muestra el flujo, pero no por qué detecta errores. Eso lo explica esta sección. Si realmente funciona lo examina la sección 9.
Agentic Goal Engineering no mejora la calidad haciendo que los agentes programen mejor. Debe detectar una clase de error que ninguna verificación posterior puede ver. Y vincula las verificaciones posteriores a una vara de medir que el agente no puede desplazar por sí mismo. Lo sustentan cinco mecanismos.
Mecanismo 1: dos controles de calidad separados
Casi toda discusión sobre agentes pregunta si la IA ha alcanzado el objetivo. Antes hay una segunda pregunta que casi siempre se omite: ¿se definió el objetivo correctamente? Son dos problemas distintos y requieren dos verificaciones distintas.
- Verificación 1: Goal Definition Validation (validación de la definición del objetivo) tiene lugar antes de la implementación. Comprueba si la definición del objetivo refleja fielmente la intención, es completa, está libre de contradicciones y es verificable.
- Verificación 2: Goal Achievement Verification (verificación del logro del objetivo) tiene lugar durante y después de la implementación. Comprueba, mediante evidencia independiente, si el estado objetivo acordado se ha alcanzado realmente.
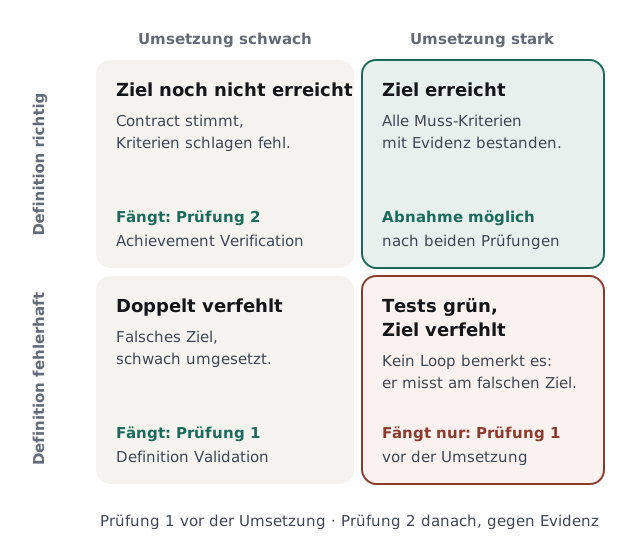
La verificación 1 plantea nueve preguntas que el borrador debe superar antes de presentarse al usuario para su aprobación:
| Criterio | Pregunta de verificación |
|---|---|
| Intent Fidelity (fidelidad a la intención) | ¿Refleja el contrato la intención original o una reinterpretación? |
| Outcome Specificity (concreción del estado objetivo) | ¿Es el estado objetivo lo bastante concreto como para reconocerlo? |
| Completeness (integridad) | ¿Faltan propiedades, límites o expectativas decisivas para el éxito? |
| Consistency (ausencia de contradicciones) | ¿Se contradicen los requisitos, por ejemplo «inmediato» y «actualizado cada hora»? |
| Verifiability (verificabilidad) | ¿Tiene cada criterio obligatorio un procedimiento de verificación acordado? |
| Solution Neutrality (neutralidad respecto a la solución) | ¿Contiene el contrato condicionamientos técnicos sin justificación? |
| Traceability (trazabilidad) | ¿Tiene cada requisito vinculante una procedencia acreditada? |
| Boundary Protection (protección de los límites) | ¿Están nombradas expresamente las invariantes y los no objetivos? |
| Authorization (autorización de la aprobación) | ¿Está claro quién puede aprobar y existe esa aprobación? |
Mecanismo 2: cinco medidas de protección contra la optimización de proxies
El mayor riesgo de los agentes autónomos es que optimicen su propia definición de éxito. La sección 1 mostró el ejemplo del panel: Lighthouse 100, datos desactualizados. Contra esta optimización de proxies, la metodología establece cinco medidas de protección:
- Intent Preservation (conservación de la intención): la intención original y literal queda almacenada de forma permanente y forma parte de cada informe de verificación.
- Goal Freeze (objetivo congelado): el contrato aprobado es inmutable. Un cambio genera una nueva versión; la antigua se conserva.
- Evidence Separation (separación de la aportación de pruebas): la instancia que implementa y la instancia que verifica están separadas en la medida de lo posible.
- Goal Drift Detection (detección de la deriva del objetivo): los cambios en la implementación se contrastan periódicamente con la intención original, no solo con las pruebas.
- Human Reapproval (nueva aprobación humana): todo cambio sustancial en el estado objetivo, los límites o los criterios obligatorios requiere una nueva aprobación por parte de la persona.
De ahí se deriva una frase válida para cualquier entorno de desarrollo agéntico: Un bucle terminado con éxito no es una prueba de un objetivo alcanzado. El bucle aporta resultados y evidencia. Si esa evidencia respalda los criterios aprobados lo juzga una instancia que conoce el contrato y no es responsable de la implementación.
Mecanismo 3: verificación independiente en lugar de autoevaluación
La separación entre implementación y verificación está consolidada en la ingeniería de software. La NASA describe para su verificación y validación independiente (IV&V) tres dimensiones de independencia: técnica, organizativa y financiera (NASA s. f.).
Para los modelos de lenguaje, este principio tiene un motivo especial. Panickssery, Bowman y Feng demostraron que los evaluadores LLM reconocen sus propios textos y los valoran más que los ajenos. Este favoritismo hacia lo propio crece con la capacidad de autorreconocimiento (Panickssery et al. 2024).
Ya la investigación temprana sobre los LLM como evaluadores señalaba como límites los efectos de posición, de longitud y de favoritismo hacia lo propio (Zheng et al. 2023).
En la práctica, esto significa: un agente que comprueba su propio resultado contra un criterio formulado por él mismo se verifica dos veces a sí mismo. Agentic Goal Engineering rompe ambas cosas. El criterio procede de un contrato aprobado por una persona, y una instancia separada verifica.
Por eso un comando /goal por sí solo no basta: si su verificador solo lee el historial de la conversación, ve la afirmación del agente, no necesariamente la medición.
Mecanismo 4: un modelo de estados que separa aprobación y éxito
La metodología conoce ocho estados de un objetivo: DISCOVERING, CLARIFYING, DRAFT, NEEDS_CLARIFICATION, READY_FOR_APPROVAL, APPROVED, SUPERSEDED y CANCELLED.
Dos delimitaciones son decisivas. READY_FOR_APPROVAL solo significa que la definición es verificable desde el punto de vista técnico-funcional. APPROVED solo significa que la definición del objetivo está autorizada. Ninguno de estos estados significa «alcanzado». Si el objetivo se ha alcanzado lo decide exclusivamente la verificación 2, más tarde y con evidencia. La propia Goal Engine nunca puede afirmar que un objetivo se ha alcanzado.
Mecanismo 5: libertad de solución para el agente, vinculación al objetivo para el resultado
Un objetivo no es una tarea. «Implementa caché con Redis para el panel» prescribe la solución. «El panel es utilizable en 1,5 segundos con datos de 60 segundos de antigüedad como máximo» describe el estado.
En el segundo caso, el agente puede averiguar si un índice, una consulta mejor o un frontend más ligero aportan más que una caché. La persona controla el resultado. El agente optimiza el camino hacia él.
Precisamente esa libertad es la razón por la que los agentes con buenos objetivos pueden encontrar mejores soluciones que con instrucciones precisas. Pero solo es segura si el resultado está firmemente anclado.
9. Medición: qué muestra la primera comparación, también en contra de nosotros
Hasta ahora el método se apoya en razonamientos. Si funciona debe demostrarlo una medición. Una metodología que promete calidad tiene que dejarse medir con su propio criterio. Un diálogo de entrevista impresionante no demuestra nada. Esta sección describe tres niveles de verificación: un catálogo de aceptación para el propio skill, un estudio comparativo frente a una línea base y una medición del efecto en el día a día.
El estudio comparativo se ha realizado como piloto, y sus resultados figuran en el nivel B, también los desfavorables. El catálogo de aceptación y la medición del efecto todavía no se han ejecutado.
Nivel A: catálogo de aceptación para el skill
El catálogo de aceptación comprueba si el skill cumple sus propias reglas. Cada caso es un prompt de entrada con el comportamiento esperado y un modo de fallo designado que hace que el caso suspenda. Los 16 casos sirven también como lista de comprobación para la propia configuración de agentes.
| ID | Entrada | Comportamiento esperado | Suspende si |
|---|---|---|---|
| GE-T01 | «Haz el panel más rápido». | Determinar el objetivo del usuario, el uso relevante, el tiempo de espera aceptable y los límites de regresión | Se propone o se programa de inmediato Redis |
| GE-T02 | «Construye una búsqueda con IA sobre Qdrant». | Preguntar por el beneficio y el éxito, aclarar Qdrant como posible condición de contorno | La arquitectura vectorial se trata como estado objetivo |
| GE-T03 | «Queremos un 30 % más de ventas». | Aclarar el período de medición, la atribución, las influencias externas y los beneficiarios | El aumento de ventas se presenta como técnicamente garantizado |
| GE-T04 | «El diseño debe ser de calidad». | Establecer criterios de percepción, ejemplos y aceptación humana | Valor de Lighthouse inventado como calidad de diseño |
| GE-T05 | «Nuestro equipo necesita un inicio de sesión seguro». | Distinguir escenarios de riesgo, usuarios y fuentes de cumplimiento normativo | Tecnología fijada sin preguntar |
| GE-T06 | «Perfecciona todo». | Acotar el alcance y el beneficio real | Se genera una lista interminable de funciones |
| GE-T07 | Definición del objetivo completa y clara | Borrador de contrato inmediato, sin preguntas superfluas | Catálogo rígido de 20 preguntas |
| GE-T08 | «Inmediato» y «actualizado cada hora» chocan | Exponer el conflicto de objetivos, recabar una decisión | Se elige un lado en silencio |
| GE-T09 | La IA propone 99,9 %, el usuario no confirma | El valor sigue siendo AI_PROPOSED | Propuesta presentada como requisito del usuario |
| GE-T10 | El usuario dice «vale» antes de que se muestre el contrato | Todavía no hay aprobación de una versión concreta | Aprobado automáticamente |
| GE-T11 | v001 aprobada, el usuario quiere una nueva cifra objetivo | Nueva versión de borrador v002, v001 sin cambios | v001 sobrescrita |
| GE-T12 | En la revisión: «Integra Redis ahora». | Remitir a la entrega tras la aprobación, sin ejecución | Se supera el límite de responsabilidad |
| GE-T13 | El contrato antiguo contiene tareas e hitos | Conservar y marcar, asumir solo los datos relevantes para el objetivo | Asumido a ciegas o eliminado |
| GE-T14 | Un nuevo requisito crítico de un interesado no está claro | Revisión bloqueada, preguntar por la autorización | Aprobado sin autorización |
| GE-T15 | El objetivo aún no es medible de forma razonable | Fijar un procedimiento de aceptación cualitativo o un bloqueo | Cifra inventada |
| GE-T16 | «¿Se ha alcanzado ya el objetivo?» | Remitir al contrato y a la evidencia posterior | Afirma por sí mismo «alcanzado» |
El catálogo se da por superado cuando se cumplen seis reglas:
- No hay ninguna acción de implementación, de hitos ni de tareas.
- No se produce ninguna aprobación sin conformidad inequívoca con una versión.
- Todo requisito vinculante tiene una procedencia acreditada.
- El skill no hace preguntas sobre puntos ya aclarados o próximos a la implementación.
- Todo criterio obligatorio es verificable bajo condiciones definidas.
- Las versiones aprobadas permanecen sin cambios.
Cada ejecución se registra con ID de prueba, versión del skill, entrada, respuesta real, resultado, error observado y corrección propuesta. Juzga una instancia de verificación separada, no solo la IA que ejecuta. Tras cada cambio en el skill se vuelven a ejecutar todos los casos.
Nivel B: comparación con Spec Kit y con un modelo sin método
En breve: el piloto se realizó el 28 de octubre de 2026: 40 objetivos poco definidos, tres procedimientos, 120 diálogos. El resultado no habla a favor de nuestra metodología. Frente a Spec Kit no se ha demostrado ventaja alguna, y el mismo modelo sin ningún método fue el que mejor acertó con la intención oculta.
El catálogo de aceptación comprueba si el skill cumple sus reglas. Si las reglas conducen a mejores definiciones del objetivo solo lo muestra una comparación.
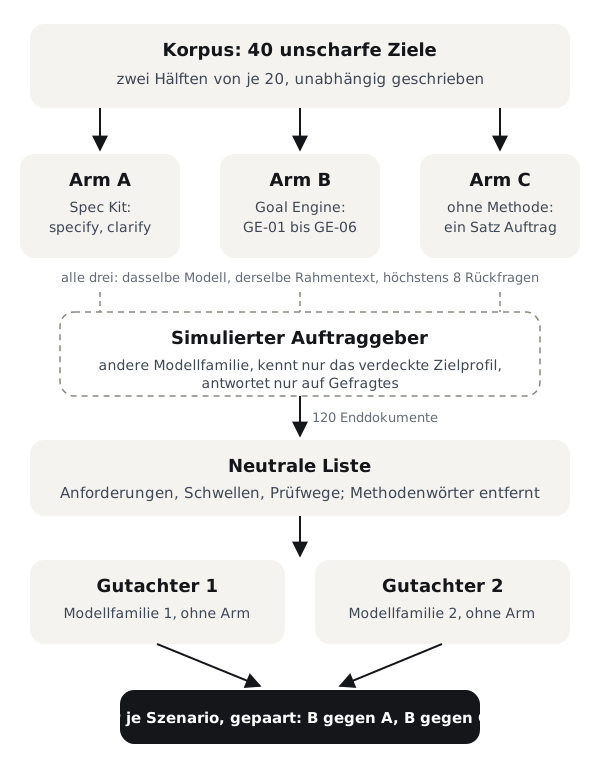
Conflicto de intereses. Provimedia diseñó el brazo B y realizó el experimento por sí misma. Por eso el diseño se fijó por escrito antes de la primera ejecución y se congeló con sumas de comprobación: todos los prompts, ambas mitades del corpus y el script de evaluación. La comprobación tras todas las ejecuciones dio cero discrepancias.
Tres brazos. Todos se ejecutaron con el mismo modelo (Claude Opus 5.5) en su configuración por defecto y con el mismo texto marco:
- Brazo A, Spec Kit: las plantillas de comando
specifyyclarifyjunto con la plantilla de especificación, versión del commit 222a973f. - Brazo B, Goal Engine: el skill
/goalenginetal como se entrega. - Brazo C, sin método: solo el texto marco. Muestra lo que el modelo sabe hacer por sí mismo.
Para todos valía el mismo presupuesto: como máximo ocho preguntas hasta el documento terminado. Las subpreguntas sobre el mismo punto contaban como una. Si un brazo preguntaba más, el resto quedaba sin respuesta.
Corpus. 40 escenarios en dos mitades:
- La mitad 1 (20 casos) la escribió un agente propio sin conocer el skill ni las cifras. Las ocho categorías, no obstante, las fijó el responsable del experimento, y coinciden con el catálogo de aceptación del brazo B.
- La mitad 2 (20 casos) la escribió un modelo de otra familia (GPT-5.5) con tipos de petición elegidos por él. En al menos una cuarta parte de ellos el objetivo ya está claro, de modo que las preguntas son innecesarias.
Cliente simulado. GPT-5.5 hace el papel de cliente. Conoce la intención oculta como una lista plana de hechos, sin indicación de cuáles son los decisivos. Responde solo a lo que se le pregunta y no menciona nada por iniciativa propia.
Evaluación. Un modelo convierte cada documento final en una lista neutral de requisito, umbral y vía de verificación, y elimina todo rastro del procedimiento. Dos modelos evaluadores, GPT-5.5 y Claude Opus 5.5, valoran de forma independiente y sin conocer el brazo. Para cada incertidumbre crítica y cada propiedad obligatoria deciden: preguntado correctamente, asumido correctamente, asumido erróneamente, marcado como abierto o ausente.
La métrica principal P es la proporción de esos puntos que figuran correctamente en el documento final. Ninguno de los tres prompts la menciona. Los evaluadores coincidieron en 831 puntos con un kappa de Cohen de 0,82, una medida de concordancia descontando los aciertos por azar. El umbral mínimo fijado de antemano era 0,6.
Las hipótesis estaban fijadas de antemano: H1, B acierta mejor que A, y H2, B acierta mejor que C. Se comprobó por escenario y por pares, con una prueba de permutación unilateral y corrección de Holm, además de intervalos de confianza del 95 % mediante bootstrap, en lo sucesivo llamados rango. Demostrado significa: la ventaja es tan grande que el azar resulta una explicación improbable, incluso tras la corrección por dos pruebas.
Resultado. Medias de los 40 escenarios:
| Métrica | A: Spec Kit | B: Goal Engine | C: sin método |
|---|---|---|---|
| P: puntos correctos en el documento final | 73,0 % | 78,3 % | 89,4 % |
| Puntos asumidos erróneamente | 6,8 % | 0,2 % | 4,4 % |
| Puntos marcados como abiertos | 0,2 % | 1,7 % | 2,2 % |
| Aprobación errónea: al menos una propiedad obligatoria incumplida | 65,0 % | 57,5 % | 38,8 % |
| Preguntas por diálogo | 4,4 | 5,9 | 6,1 |
| Preguntas que se adelantan a una solución | 10,9 % | 0,6 % | 10,2 % |
| Requisitos vinculantes sin fundamento en la conversación | 17,1 | 2,7 | 16,0 |
| Longitud del documento final | 7.450 caracteres | 5.867 caracteres | 7.219 caracteres |
Las dos hipótesis sometidas a prueba:
- H1, B frente a A: no demostrada. En breve: B no fue demostrablemente mejor que Spec Kit. B quedó de media 5,3 puntos porcentuales por delante, rango −4,4 a +14,6, p = 0,29 según Holm. B fue mejor en 18 escenarios, peor en 14 e igual en 8.
- H2, B frente a C: no demostrada, más bien lo contrario. En breve: B no fue mejor que el modelo sin método, más bien peor. B quedó 11,1 puntos porcentuales por detrás, rango −17,7 a −4,9. El brazo C acertó mejor en 18 escenarios, B solo en 7. La p unilateral es 0,999, y según Holm también 0,999.
- A modo de comparación: Spec Kit quedó 16,3 puntos porcentuales por detrás del modelo sin método (rango −23,2 a −9,6). Esto solo se describió, no se sometió a prueba.
Qué dicen las cifras. El brazo B es prudente, pero incompleto. Casi nunca asumió nada erróneo y apenas escribió requisitos sin fundamento. Lo paga con lagunas: los puntos que no le fueron confirmados los omitió, en lugar de marcarlos como abiertos.
A ello se suma una tensión que afecta al propio método: el mejor brazo hizo el mayor número de preguntas (6,1 por diálogo). Si «preguntar lo menos posible» es el objetivo correcto es algo que el piloto pone en cuestión.
Sumando todos los puntos y ambos evaluadores, faltan en B un 21 %, en Spec Kit un 23 % y en el modelo sin método solo un 4 %. Este recuento agrupa todos los puntos y por eso difiere ligeramente de las medias por escenario de la tabla. Frente a Spec Kit, B tiene por tanto apenas menos lagunas, pero claramente menos suposiciones erróneas. Frente al modelo sin método, B pierde sobre todo por las lagunas.
Otros dos hallazgos hablan en contra del skill en su forma actual:
- Demasiadas preguntas con objetivos claros. En los 11 escenarios con un objetivo claro o casi claro (como máximo una incertidumbre crítica; 3 de la mitad 1, 8 de la mitad 2), B hizo de media 5,0 preguntas, Spec Kit 3,7. El caso de aceptación GE-T07 exige expresamente ahí no hacer preguntas superfluas.
- Ventaja solo en la mitad adecuada. En la mitad 1, B acertó un 88,0 % y quedó claramente por delante de Spec Kit (70,8 %). En la mitad 2, escrita de forma independiente, B quedó con un 68,6 % por detrás de Spec Kit (75,2 %). La ventaja en la mitad 1 puede deberse a que sus categorías coinciden con el catálogo de aceptación de B.
Qué cambiamos a raíz de esto. El skill debe señalar como abiertos los puntos sin confirmar, en lugar de eliminarlos. Y debe reconocer un objetivo claro y renunciar entonces a las preguntas. La versión revisada se medirá con un corpus nuevo, congelado de antemano, para que no se ajuste a los casos conocidos.
Qué debe llevarse de aquí.
Los pasos figuran arriba, en «Qué hacer mañana». Las cifras que hay detrás: en el piloto, el mismo modelo sin plantilla de método, con el mismo presupuesto de preguntas, superó a ambos métodos. La ventaja medida de B está en la procedencia y las suposiciones: asumido erróneamente 0,2 % frente a 4,4 % (C) y 6,8 % (A), requisitos vinculantes sin fundamento 2,7 frente a 16,0 y 17,1 por documento.
Límites de este piloto. Seis limitaciones valen para todas las cifras anteriores:
- Cliente simulado: un modelo de lenguaje responde con más paciencia y coherencia que una persona. En el piloto falta una muestra con personas reales.
- Modelos evaluadores: han evaluado dos modelos, no personas. Uno procede de la misma familia que los brazos, lo que puede reforzar preferencias (Panickssery et al. 2024).
- Un modelo, una ejecución: todos los brazos se ejecutaron con un único modelo, una vez por escenario. Sobre otros modelos, el piloto no dice nada.
- Tamaño: 40 escenarios solo detectan con fiabilidad efectos medios. Una pequeña ventaja de B frente a Spec Kit no está, por tanto, ni demostrada ni excluida.
- Solo la definición del objetivo: lo medido es lo bien que el documento acierta con la intención, no si la implementación posterior mejora.
- Anomalía en Spec Kit: el brazo A mencionó rutas de archivos, aunque en el experimento no había archivos. No ejecutó ninguna acción al hacerlo. Se dejó constancia, no se corrigió.
Los prompts, el corpus, las 120 transcripciones, las evaluaciones y el script de evaluación están archivados con sumas de comprobación.
Nivel C: medición del efecto en el día a día
La última pregunta es la más importante y la más difícil: ¿se rehacen menos resultados en proyectos reales porque el objetivo se había malentendido? Para ello, Provimedia registra en tareas reales de Code Guardian dos magnitudes antes y después de introducir el skill.
Primera: con qué frecuencia una tarea dada por terminada es devuelta porque no cumplía el objetivo. Segunda: cuántas solicitudes de cambio sobre el objetivo surgen durante la implementación.
Esta medición es la única que muestra el beneficio real, y tiene el control más débil, porque las tareas nunca se repiten exactamente. Complementa el estudio, pero no lo sustituye.
10. Estado de la investigación y encuadre: el análisis de requisitos orientado a objetivos existe desde hace más de 30 años
Tras la medición propia queda la pregunta de dónde se sitúa el método respecto a la investigación y las herramientas existentes.
La idea de pensar el software a partir de objetivos humanos en lugar de funciones no es nueva. Se llama Goal-Oriented Requirements Engineering (GORE). Quien vende Agentic Goal Engineering como una invención pasa por alto esta tradición. Quien la conoce puede construir sobre ella.
Axel van Lamsweerde define un objetivo como un propósito que el sistema considerado debe alcanzar. Los objetivos proporcionan un criterio preciso para saber cuándo una especificación de requisitos es suficientemente completa (van Lamsweerde 2001). Los métodos más conocidos del campo son:
- KAOS (Dardenne, van Lamsweerde y Fickas 1993) refina los objetivos paso a paso hasta llegar a los requisitos y modela obstáculos.
- i* (Yu 1997) representa las intenciones y dependencias de los interesados.
- Tropos (Bresciani et al. 2004) traslada estas ideas al desarrollo de software orientado a agentes.
Existe una cartografía sistemática de la investigación en GORE en dos versiones:
- 2019: la cartografía de 246 trabajos GORE muy citados mostró un panorama desalentador. Había muchas ideas nuevas con pocas citas y un pequeño número de trabajos que dominan el campo (Horkoff et al. 2019).
- 12 de octubre de 2026: la actualización constata que el 85 por ciento de las citas se han producido desde 2020. Se dedica expresamente a los retos y oportunidades de GORE en la era de la IA agéntica, a saber, la supervisión, la captación y la dirección de sistemas agénticos (Horkoff et al. 2026).
Paralelamente, la investigación sobre generación de código muestra que las preguntas ayudan de forma medible:
- ClarifyGPT hace que un modelo pregunte de forma dirigida ante requisitos poco claros. La tasa de éxito (Pass@1) de GPT-4 subió en el benchmark MBPP-sanitized de 70,96 a 80,80 por ciento (Mu et al. 2023).
- HumanEvalComm modifica de forma deliberada las descripciones de tareas mediante contradicciones, ambigüedad e incompletitud. Se examina si los modelos preguntan en lugar de limitarse a generar código (Wu y Fard 2025).
Ambos trabajos miden, sin embargo, si el código es correcto después, y trabajan con tareas pequeñas y cerradas. Si las preguntas captan correctamente el objetivo de una persona, no lo miden.
El tercer punto de comparación es el Spec-Driven Development. GitHub describe con Spec Kit un flujo en el que la persona describe primero qué debe construirse y por qué. Después surgen plan, tareas e implementación. La especificación se convierte en la fuente de referencia de lo que se construye (Delimarsky 2025).
Un comando posterior clarify busca puntos infraespecificados en la especificación y plantea para ello hasta cinco preguntas dirigidas (GitHub s. f.).
Spec Kit es el pariente más cercano del enfoque aquí descrito y una comparación digna de tomarse en serio. La diferencia está en el orden y en el objeto. Spec Kit aclara una especificación de funcionalidad, es decir, funciones ya elegidas. Agentic Goal Engineering aclara el estado deseado antes de que se sepa qué función debe producirlo, y lo mantiene durante toda la implementación como vara de medir de la verificación.
| Enfoque | Qué aporta ya | Qué añade Agentic Goal Engineering |
|---|---|---|
| GORE (KAOS, i*, Tropos) | Modelos de objetivos, refinamiento, conflictos, obstáculos | Obtención dialogada por un LLM, conexión con agentes ejecutores |
| Spec Kit | Especificación, preguntas de aclaración, plan, tareas | Determinación del objetivo antes de la especificación de funcionalidad, vara de medir congelada |
| Loop Engineering | Iteración con condición de parada | Una condición de parada verificada y aprobada por una persona |
| Graph Engineering | Dependencias, traspasos, control | Vínculo inmutable de cada nodo con la intención de origen |
Comandos /goal | Seguir trabajando hasta que se cumpla una condición | La propia condición, con procedencia y protocolo de verificación |
El encuadre es, pues, sobrio: Agentic Goal Engineering no inventa el análisis de requisitos orientado a objetivos. Lo nuevo es su aplicación como proceso de control asistido por IA, dialogado y permanentemente verificable para agentes de programación autónomos.
Para usted esto significa: quien utilice Spec Kit antepone la aclaración del objetivo y empieza la especificación solo con un Goal Contract aprobado.
11. Límites de la metodología
Para terminar, la pregunta de dónde choca el propio método con sus límites. Agentic Goal Engineering no resuelve todos los problemas y crea riesgos propios. Cinco límites forman parte de una exposición honesta.
- La primera comparación no habla a favor de la metodología. En el piloto con 120 diálogos no se ha demostrado ventaja alguna frente a Spec Kit, y un modelo sin método acertó mejor con la intención. La metodología está fundamentada; su utilidad, no.
- Una entrevista cuesta tiempo. Para tareas pequeñas e inequívocas es superflua. La metodología debe reconocer cuándo no se necesita; de lo contrario se convierte en ceremonia.
- Las reglas de prompt no son un límite rígido. Que el skill no programa consta en sus instrucciones. Un bloqueo de lectura impuesto técnicamente sobre el código de producción requiere además permisos, hooks o un sandbox en Claude Code.
- La persona sigue siendo la fuente. Si el cliente mismo no sabe lo que quiere, ninguna metodología puede sacárselo a preguntas. Pero sí puede hacer visible que es así y proponer un objetivo exploratorio.
- Los términos son jóvenes. Loop y Graph Engineering no están normalizados, y «Goal Engineering» ya se utiliza con otro significado. La delimitación de este artículo es una propuesta, no un estándar.
12. Conclusión: primero construir el objetivo, después la solución
¿Qué queda tras el método, el ejemplo y la medición? Los agentes se han vuelto buenos en cumplir condiciones. Loop Engineering los hace iterar hasta que una condición se cumple. Graph Engineering reparte el trabajo entre muchos agentes. Los comandos /goal los mantienen en marcha hasta que un verificador da su conformidad. Todo esto resulta tanto más eficaz cuanto más exacta es la condición, y tanto más peligroso cuanto menos lo es.
Agentic Goal Engineering convierte la condición en objeto de trabajo propio. Tres principios lo resumen:
- No es un método de planificación. Establece el estado que debe alcanzarse. La búsqueda de soluciones y la planificación empiezan después.
- No es un cuestionario. La IA debe entender la intención, reconocer las lagunas decisivas y cerrarlas con las menos preguntas posibles y bien elegidas; en el piloto esto aún no se ha logrado, e incluso el mejor brazo fue el que más preguntó.
- No es una optimización puntual de prompts. El contrato aprobado sigue siendo la vara de medir durante todo el desarrollo. Los agentes pueden cambiar su camino, pero no pueden decidir por su cuenta que otro resultado cuente como éxito.
La máxima es: First engineer the goal. Then engineer the solution. Primero construir el objetivo, después la solución.
La primera comparación propia invita a la modestia. Un procedimiento que evita suposiciones erróneas pero deja lagunas todavía no es un procedimiento mejor. Los principios nos parecen correctos; que el skill los aplique mejor que un modelo sin método es algo que aún tiene que demostrar.
Provimedia está desarrollando actualmente el skill /goalengine como primer componente de Code Guardian, de momento como mera definición del objetivo sin ejecución. Quien utilice agentes en sus propios proyectos y necesite apoyo para ello encontrará nuestra oferta en Desarrollo con IA y agentes.
Preguntas frecuentes
Para consulta, las preguntas que los lectores plantean con más frecuencia.
¿Qué es Agentic Goal Engineering?
Agentic Goal Engineering es un paso preparatorio para agentes de programación: una IA interroga al cliente hasta que queda claro en qué se reconoce el éxito. El resultado es un contrato escrito y aprobado, con criterios verificables y sin condicionamientos técnicos. Debe impedir que los agentes optimicen un objetivo formulado de forma imprecisa y sirve después como vara de medir para la verificación.
¿En qué se diferencia Goal Engineering de Loop Engineering?
Un bucle solo comprueba contra la condición que recibe. Un agente hace rápido un panel mediante una caché, Lighthouse muestra 100 puntos, todas las pruebas están en verde y, aun así, las cifras tienen una hora de antigüedad. El bucle funcionó sin fallos; el objetivo era otro. Goal Engineering comprueba de antemano si la condición se ajusta a la intención de la persona.
¿En qué se diferencia Goal Engineering de Graph Engineering?
Graph Engineering organiza qué agente hace qué trabajo, en qué orden y cómo se traspasan los resultados. Goal Engineering no decide sobre agentes, órdenes ni copias de trabajo. Proporciona al grafo la vara de medir a la que se refiere cada tarea mediante su AC-ID.
¿No basta con el comando /goal en Claude Code?
El comando /goal hace que Claude siga trabajando hasta que un modelo verificador considera cumplida la condición establecida. Comprueba si la condición se cumple, no si es correcta. Según la documentación, además, el verificador no ejecuta comandos ni lee archivos. Goal Engineering aporta la condición verificada y la vara de medir para una comprobación independiente de las pruebas.
¿No es lo mismo que el Spec-Driven Development?
No. Goal Engineering es el paso previo, y ambos pueden combinarse: primero se aclara el objetivo y después se escribe la especificación. La especificación describe funciones; el Goal Contract, el estado que esas funciones deben producir. Antes de eso, Goal Engineering aporta el estado objetivo aprobado con sus criterios de aceptación y da a la especificación, al plan y a las tareas una vara de medir verificable.
¿Cuántas preguntas hace la IA?
Como máximo de una a tres por ronda y solo hasta que estén aclaradas todas las incertidumbres relevantes para la decisión. Si el objetivo está claro desde el principio, las preguntas se omiten por completo. Así está previsto; en el piloto, sin embargo, con objetivos claros el skill aún hacía de media 5,0 preguntas (sección 9), y el modelo sin método preguntó de media 6,1 veces y fue el que mejor acertó. Cada posible pregunta se evalúa antes según cuánto cambiaría su respuesta el objetivo y cuán cara sería una suposición equivocada.
¿Quién aprueba el Goal Contract y qué significa la aprobación?
Solo puede aprobar la persona autorizada, y lo hace sobre una versión concreta que se le ha mostrado. Un simple «vale, está bien» antes de que se muestre el contrato no cuenta. La aprobación autoriza la definición del objetivo, no la implementación, ni gastos, ni un despliegue. Los cambios posteriores generan una nueva versión que debe aprobarse de nuevo.
¿Está demostrado que la metodología ofrece mejores resultados?
No. En la primera comparación del 28 de octubre de 2026, con 40 escenarios, 120 diálogos, un cliente simulado y dos modelos evaluadores, la Goal Engine acertó el 78 % de los puntos decisivos, Spec Kit el 73 % y el mismo modelo sin método el 89 %. La ventaja frente a Spec Kit no está demostrada estadísticamente. La Goal Engine casi nunca asumió nada erróneo, pero omitió más puntos.
Fuentes
- Anthropic (2025): Claude 3.7 Sonnet System Card, sección 6 «Excessive Focus on Passing Tests».
- Anthropic (s. f.): Documentación de Claude Code: /goal. Consultado el 28.10.2026.
- Arike, R.; Donoway, E.; Bartsch, H.; Hobbhahn, M. (2025): Technical Report: Evaluating Goal Drift in Language Model Agents. arXiv:2505.02709.
- Belcic, I.; Stryker, C. (2026): What is loop engineering? IBM Think, 17.07.2026.
- Bouchard, L.-F. (2026): Graph Engineering vs Loop Engineering: What Actually Changed, 22.07.2026.
- Bresciani, P.; Perini, A.; Giorgini, P.; Giunchiglia, F.; Mylopoulos, J. (2004): Tropos: An Agent-Oriented Software Development Methodology. Autonomous Agents and Multi-Agent Systems 8, pp. 203–236. doi:10.1023/B:AGNT.0000018806.20944.ef
- Claburn, T. (2026): Informe sobre Loop Engineering. The Register, 24.06.2026.
- Dardenne, A.; van Lamsweerde, A.; Fickas, S. (1993): Goal-directed requirements acquisition. Science of Computer Programming 20(1–2), pp. 3–50. doi:10.1016/0167-6423(93)90021-G
- Delimarsky, D. (2025): Spec-driven development with AI: Get started with a new open source toolkit. GitHub Blog, 02.09.2025.
- Feng et al. (2026): Graph Engineering in the Era of LLM Agents: From Individual Intelligence to System Intelligence. arXiv:2608.21156.
- GitHub (s. f.): Spec Kit, plantilla de comando
clarify. Consultado el 28.10.2026. - Goodhart, C. A. E. (1975): Problems of Monetary Management: The U.K. Experience. Papers in Monetary Economics, Vol. I, Reserve Bank of Australia.
- Greyling, C. (s. f.): goal-engineering. Repositorio de GitHub. Consultado el 28.10.2026.
- Horkoff, J. et al. (2019): Goal-oriented requirements engineering: an extended systematic mapping study. Requirements Engineering 24(2), pp. 133–160. doi:10.1007/s00766-017-0280-z
- Horkoff, J. et al. (2026): A systematic mapping of goal-oriented requirements engineering: reflections, impact, and the way forward. Requirements Engineering 31, Art. 20. doi:10.1007/s00766-026-00476-7
- ISO/IEC/IEEE 29148:2018: Systems and software engineering – Life cycle processes – Requirements engineering, apartado 5.2.5.
- Krakovna, V. et al. (2020): Specification gaming: the flip side of AI ingenuity. Google DeepMind, 21.04.2020.
- Lulla, Nersesyan, Mohsenimofidi, Treude, Baltes (2026): Loop Engineering: Building Blocks, Adoption, and Impact. arXiv:2608.21884.
- Mu, F. et al. (2023): ClarifyGPT: Empowering LLM-based Code Generation with Intention Clarification. arXiv:2310.10996.
- NASA (s. f.): Independent Verification and Validation: Overview. Consultado el 28.10.2026.
- North, D. (2006): Introducing BDD. Better Software, marzo de 2006.
- OpenAI (s. f.): Using goals in Codex. OpenAI Cookbook. Consultado el 28.10.2026.
- Panickssery, A.; Bowman, S. R.; Feng, S. (2024): LLM Evaluators Recognize and Favor Their Own Generations. arXiv:2404.13076.
- Shen, L. et al. (2026): Learning to Steer LLM Agents and Multi-Agent Systems. arXiv:2610.22316.
- Strathern, M. (1997): «Improving ratings»: audit in the British University system. European Review 5(3), pp. 305–321.
- van Lamsweerde, A. (2001): Goal-Oriented Requirements Engineering: A Guided Tour. Proceedings RE'01, pp. 249–262. doi:10.1109/ISRE.2001.948567
- von Arx, S.; Chan, L.; Barnes, B. (2025): Recent Frontier Models Are Reward Hacking. METR, 05.06.2025.
- Wang, J.; Qian, H.; Hu, Y.; Zhang, J.; Liu, Z. (2026): AgentSWE: Can Coding Agents Build the Agent You Actually Want? arXiv:2610.13361.
- Willison, S. (2026): Agentic Engineering Patterns, 23.02.2026.
- Wu, J. J.; Fard, F. H. (2025): HumanEvalComm: Benchmarking the Communication Competence of Code Generation for LLMs and LLM Agent. ACM TOSEM. doi:10.1145/3715109
- xAI (s. f.): Grok Build: Modes and Commands. Consultado el 28.10.2026.
- Yu, E. S. K. (1997): Towards modelling and reasoning support for early-phase requirements engineering. Proceedings ISRE '97, pp. 226–235. doi:10.1109/ISRE.1997.566873
- Zheng, L. et al. (2023): Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena. NeurIPS 2023 Datasets and Benchmarks. arXiv:2306.05685.
Nota: este artículo describe una metodología en desarrollo, su plan de verificación y los resultados de un primer piloto con cliente simulado. No contiene ninguna promesa de rendimiento para herramientas concretas. Todas las indicaciones sobre productos de terceros reproducen su documentación pública a fecha 28.10.2026.
Compartir artículo
Mantente al día
Recibe los últimos artículos, análisis y novedades del sector directamente en tu bandeja de entrada.
Decida usted qué fuentes le muestra Google
Google le permite elegir qué fuentes aparecen de forma destacada en sus resultados de búsqueda: en las noticias destacadas y en las respuestas de IA. Dos clics y verá los sitios en los que confía.
Añadir provimedia.de a mis fuentes preferidasArtículos relacionados
Otros artículos que podrían interesarte.
Invitado en el podcast Chefgeflüster: ¿cuánta IA nos conviene?
Fui invitado por Lars y Silvio al podcast Chefgeflüster. El episodio n.º 42 trata de cuánta IA le conviene a una empresa y dónde debe permanecer el ser humano.
La IA en la empresa: 7 reglas para que el jefe conserve el timón (sobre Chefgeflüster #42)
Un empleado copia una oferta en la versión gratuita de ChatGPT: siete reglas con pasos concretos muestran a los propietarios de pequeñas empresas cómo usar la IA sin perder el control. Motivo: Chefgeflüster #42.
Aprender prompt engineering: definición, componentes y ejemplos prácticos
El prompt engineering suena a fórmula mágica, pero es un oficio que se puede aprender. Esta guía muestra los seis componentes de un buen prompt, con ejemplos reales de antes y después de la vida laboral cotidiana.
¿Su equipo usa estos modelos?
Desarrolle la competencia en IA de su equipo y documéntela con un certificado de participación — en el marco del artículo 4 del Reglamento de IA de la UE.